Con el crecimiento explosivo de las bibliotecas de música digital locales, el análisis automatizado e inteligente de etiquetas de música se ha convertido en una necesidad para audiófilos y organizadores profesionales. Sin embargo, al introducir el etiquetado automático con IA, nos enfrentamos a un grave desafío de ingeniería: ¿Cómo garantizar la máxima profundidad de análisis mientras se asegura al 100% que los preciados archivos de audio originales del usuario no se corrompan?
En la primera fase de evolución de la arquitectura, resolvimos completamente esta contradicción al desacoplar la Tubería de Análisis de Audio e introducir un pionero Sistema de Borradores.
I. Arquitectura de Doble Vía para el Análisis de Audio
Para equilibrar la precisión del análisis, el rendimiento y la disponibilidad fuera de línea, desacoplamos las tareas de análisis en la capa inferior en dos vías independientes: Procesamiento de Señal Digital (DSP) puro e Inferencia de Aprendizaje Profundo (ONNX), manteniendo un flujo unificado de eventos y estados en la capa superior.
1. AudioMath: Detección de Parámetros Acústicos vía DSP puro
Para detectar BPM, Clave (Key/Camelot) y autenticar HiFi verdadero/falso, utilizamos la vía AudioMath. Esta vía opera completamente independiente de los modelos ONNX y se basa en algoritmos clásicos de DSP:
- Ventaja de Rendimiento: Lee directamente el flujo PCM decodificado del archivo de audio, calculando las ráfagas de energía y la autocorrelación en la capa Rust, lo que ahorra muchísima memoria.
- Autenticación de HiFi Verdadero/Falso: Para detectar recortes de alta frecuencia y falsos upsamplings, admitimos un passthrough dinámico de frecuencia de muestreo en la capa de preprocesamiento, analizando directamente el decaimiento espectral del audio para evitar errores introducidos por el remuestreo.
2. MusicTags: Clasificación Semántica vía ONNX
Para semánticas abstractas como Género, Estado de ánimo e Instrumentos, usamos modelos de aprendizaje profundo que se ejecutan localmente. Envueltos en una tarea unificada de larga duración audio_analysis, las salidas del modelo se asignan con precisión al conjunto de etiquetas del usuario.
[!NOTE]
Ambas vías se adhieren estrictamente a un diseño de cero dependencia de red, asegurando que todo el análisis de activos multimedia se complete 100% en el borde (localmente), cumpliendo con estándares de privacidad extremadamente altos.
II. El Pionero Sistema de Borradores
Aunque los modelos de IA son poderosos, nunca pueden igualar perfectamente las preferencias personales de un usuario el 100% de las veces. El software tradicional de gestión musical a menudo sobrescribe directamente los metadatos del audio después del análisis, lo cual es altamente destructivo para los usuarios que curan cuidadosamente sus bibliotecas personales.
Para abordar esto, introdujimos el Sistema de Borradores basado en SQLite, que es uno de los puntos centrales de nuestra arquitectura.
La lógica central del Sistema de Borradores es que ya sea por edición manual, análisis de IA o importación masiva, ninguna modificación se escribe directamente en el archivo de audio original. Primero generan un Plan de Parcheo digital, actuando como un “borrador” que se almacena de forma segura en una base de datos SQLite independiente y de alto rendimiento.
Dentro de la mesa de trabajo, los usuarios pueden previsualizar los efectos de estos borradores sin problemas. Solo cuando el usuario confirma completamente y hace clic activamente en “Aplicar Cambios”, el sistema utiliza una tubería de escritura segura atómica (escribiendo en un archivo temporal, reemplazándolo y conservando un mecanismo de reversión a través de una copia .bak) para consolidar estas etiquetas en los archivos.
III. Aplicación Práctica de la Autenticación de HiFi Verdadero/Falso
En la vía de DSP AudioMath, la autenticación de HiFi Verdadero/Falso es una característica que ejemplifica enormemente el espíritu friki de nuestro producto.
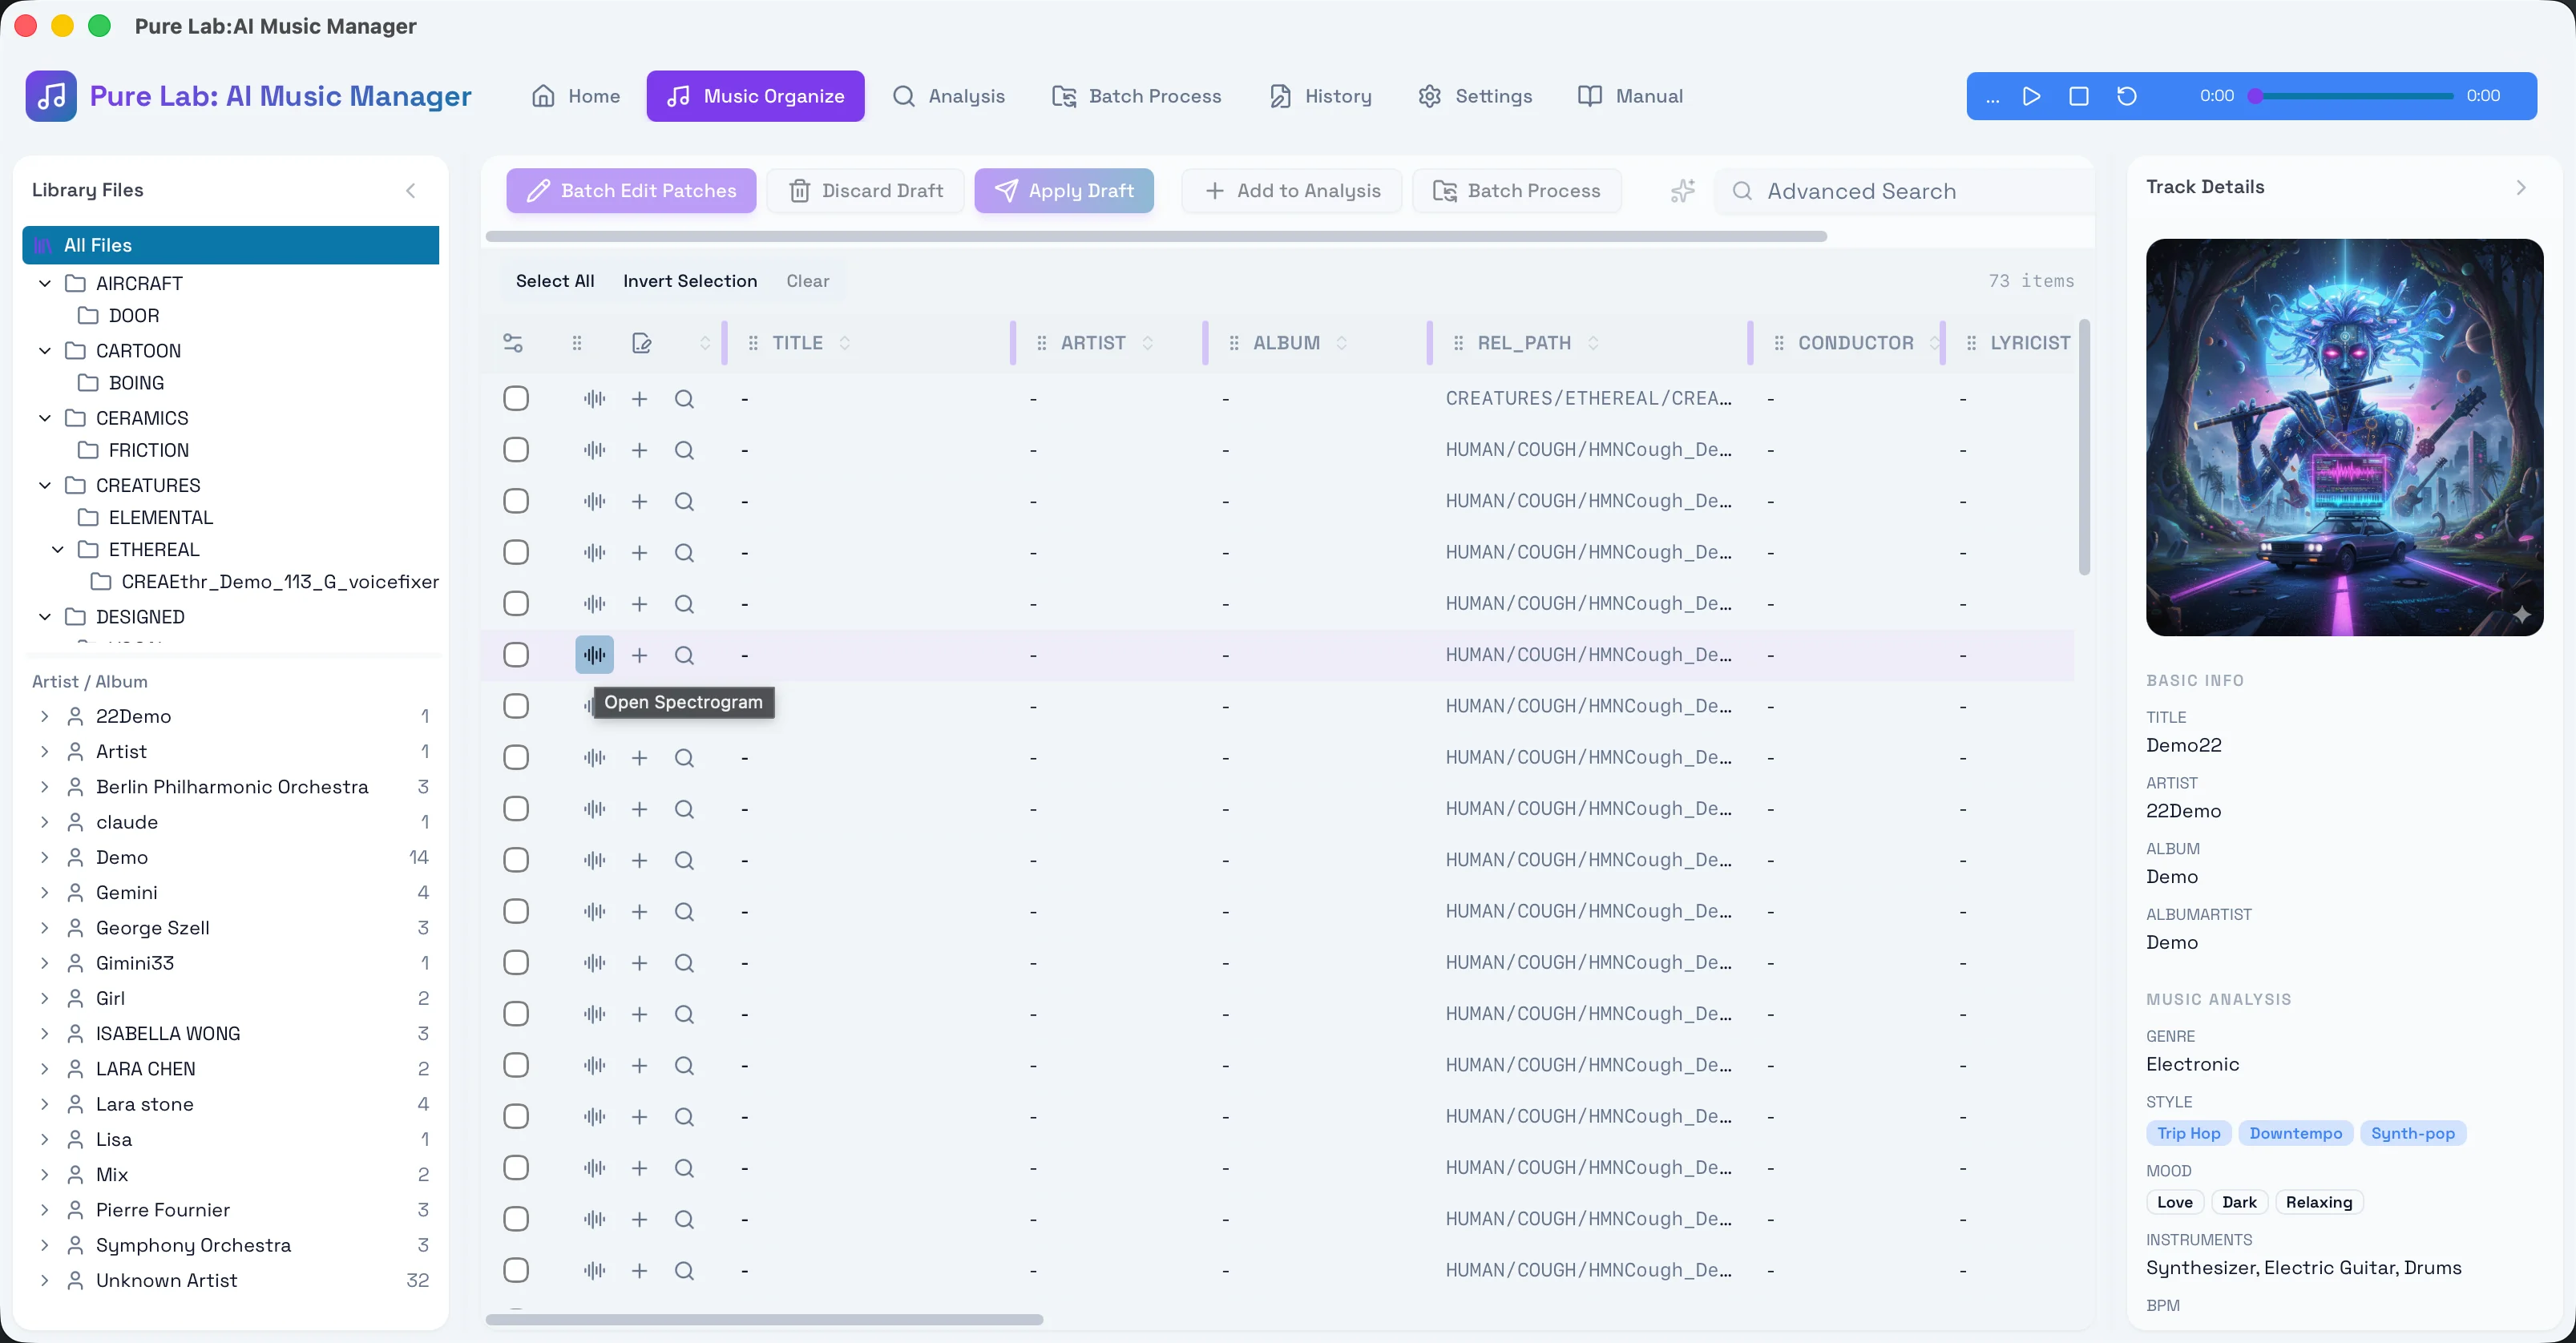
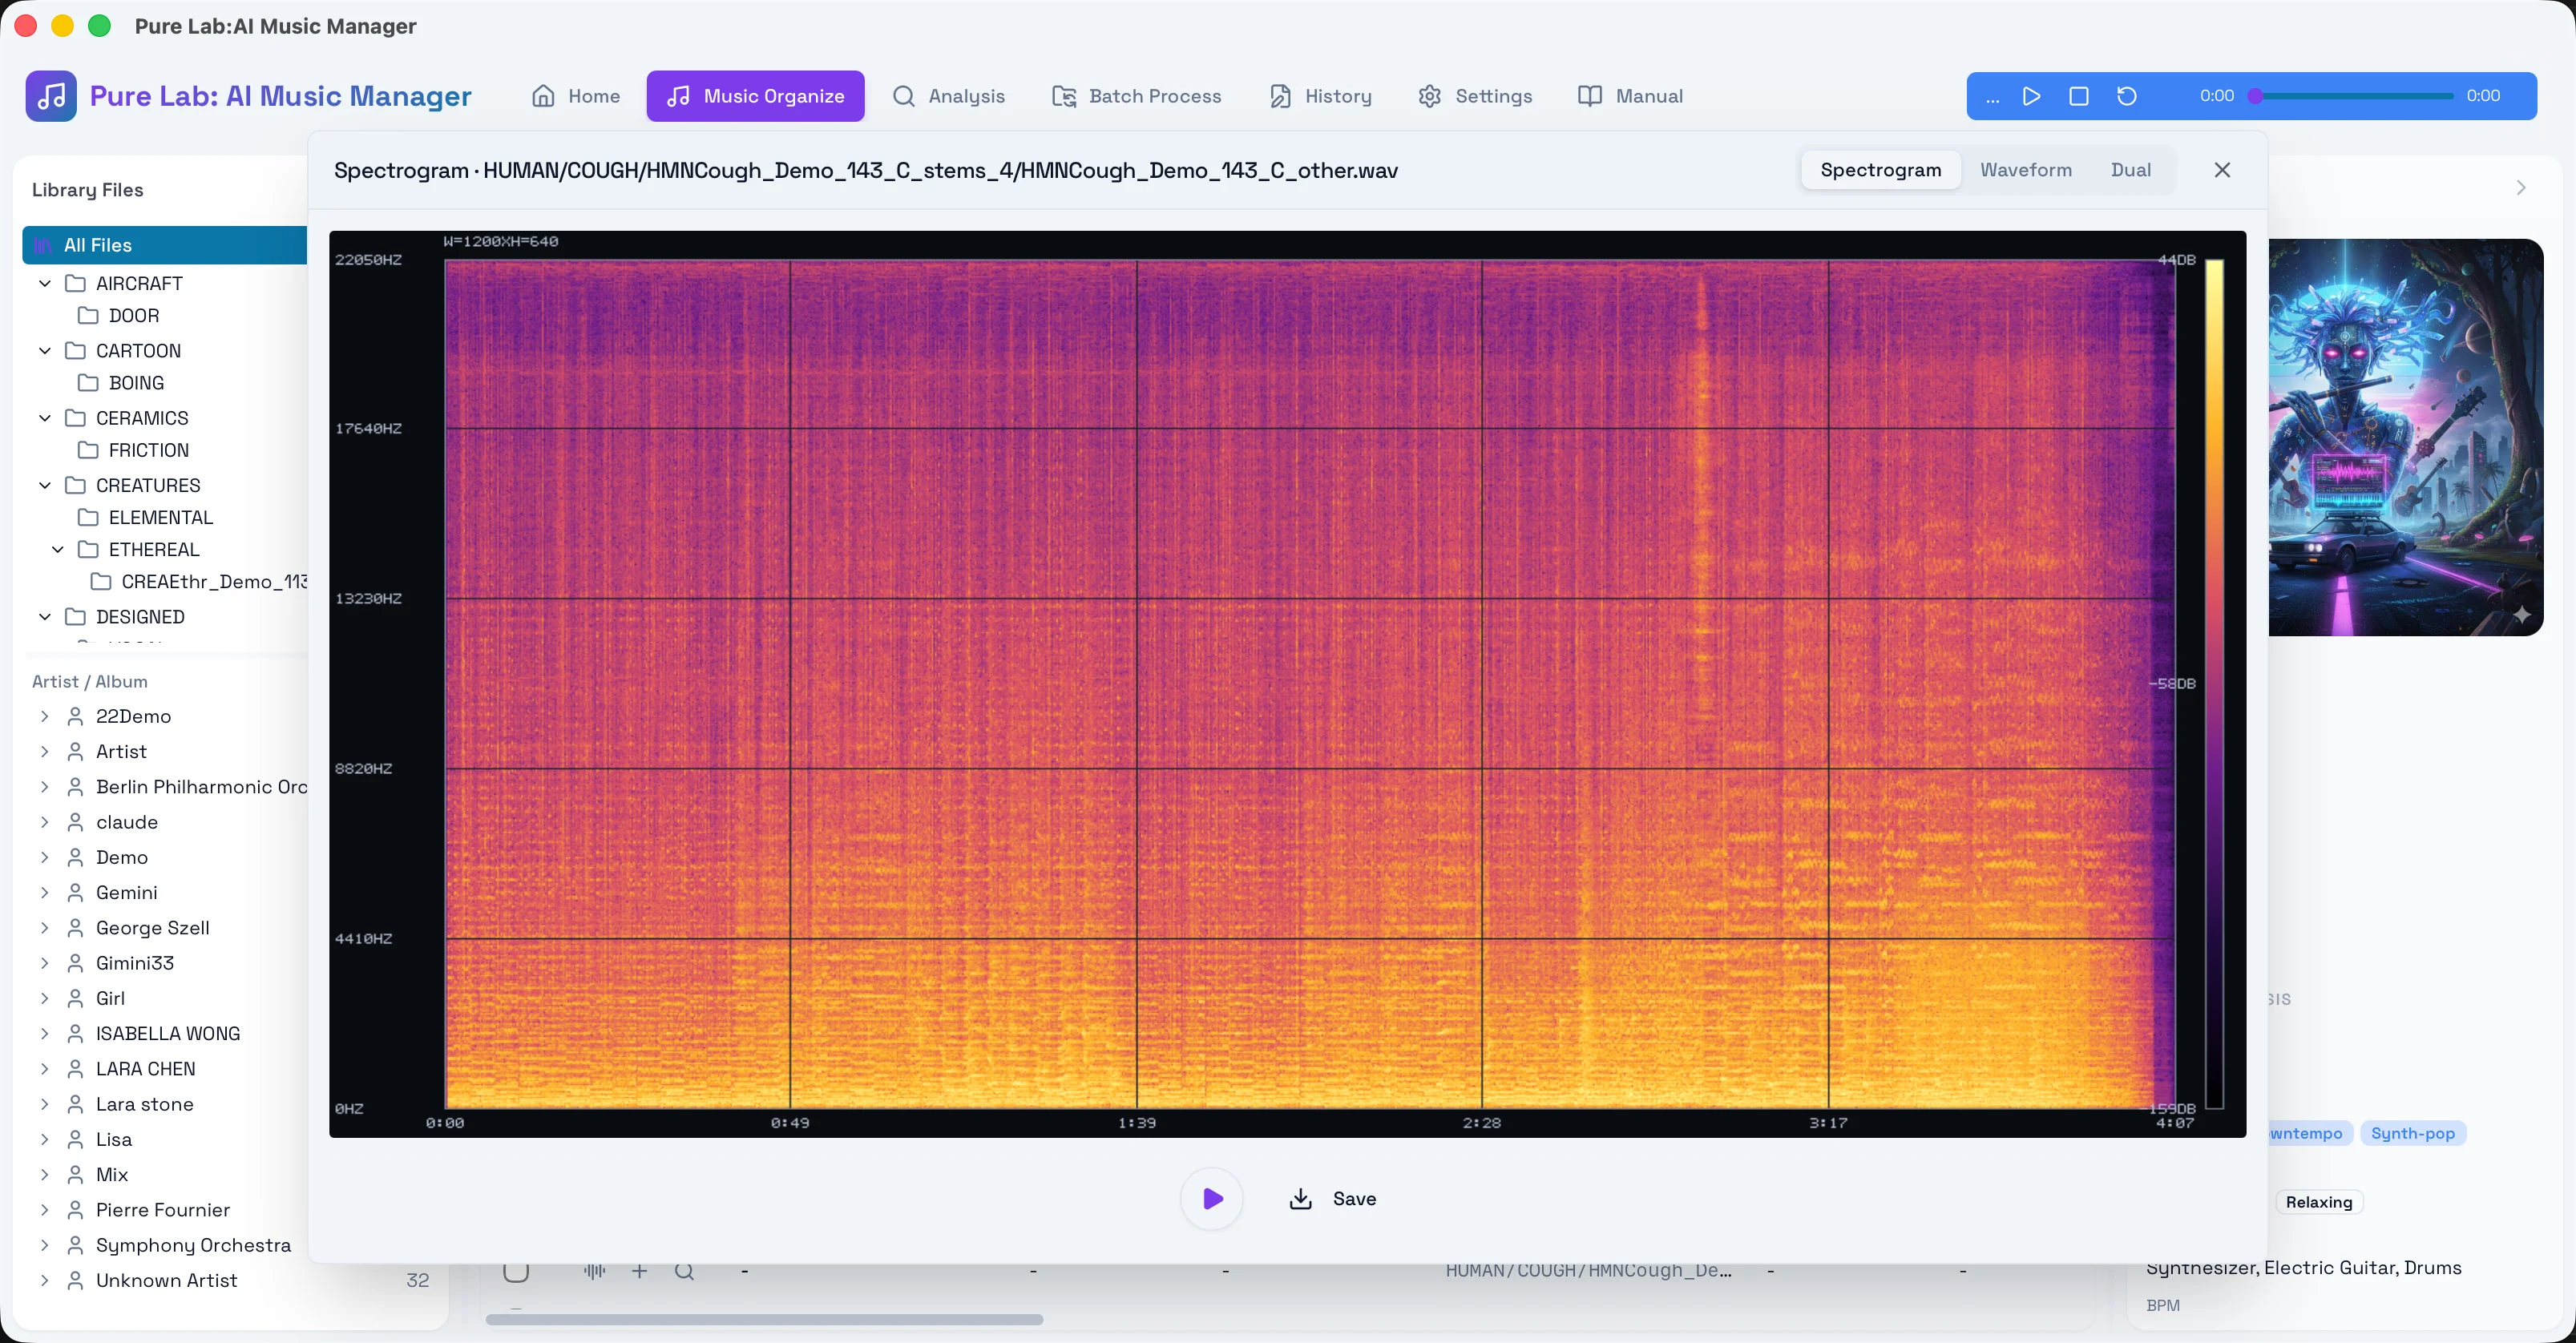
Como se muestra arriba, al organizar audio, si encuentras un formato sin pérdida de alta resolución etiquetado como “24bit/192kHz”, puedes abrir directamente el cuadro de diálogo del espectrograma. En la capa inferior del motor, calculamos el PURE_QUALITY_CUTOFF_HZ y la puntuación de confianza correspondiente:
- TRUE_HIRES (HiRes Genuino)
- SUSPICIOUS_UPSAMPLING (Sobremuestreo Sospechoso)
- SUSPICIOUS_LOSSY (Pérdida Sospechosa)
Para evitar juzgar erróneamente los DSDs originales (el moldeado de ruido de alta frecuencia provocado por los formatos DFF/DSF suele ser juzgado erróneamente por los algoritmos tradicionales), integramos este proceso profundamente en la etapa del decodificador, extrayendo la cascada de decaimiento de energía correspondiente a la frecuencia de muestreo PCM nativa. Esto permite que el sistema prevenga problemas de forma inteligente y precisa antes de que el usuario decida escribir las etiquetas.
Conclusión
A través de estos dos canales principales, AI Music Organizer garantiza la privacidad de los datos locales al tiempo que es pionero en una ruta de rendimiento y seguridad para el análisis de metadatos de etiquetas. En las próximas series de análisis técnico, también profundizaremos en el motor de búsqueda subyacente y la arquitectura semántica multilingüe, así que mantente atento.