В связи с взрывным ростом локальных цифровых музыкальных библиотек, автоматизированный и интеллектуальный анализ музыкальных тегов стал необходимостью для аудиофилов и профессиональных организаторов. Однако при внедрении автоматического тегирования с помощью ИИ мы столкнулись с серьезной инженерной проблемой: как гарантировать максимальную глубину анализа, при этом на 100% гарантируя, что драгоценные оригинальные аудиофайлы пользователя не будут испорчены?
На первом этапе эволюции архитектуры мы полностью решили это противоречие, отделив Конвейер аудиоанализа и внедрив передовую Систему черновиков (Draft System).
I. Двухполосная Архитектура для Аудиоанализа
Чтобы сбалансировать точность анализа, производительность и доступность в автономном режиме, мы разделили задачи анализа на нижнем уровне на две независимые полосы: чистую Цифровую Обработку Сигналов (DSP) и Глубокое Обучение (ONNX), сохранив единый поток событий и состояний на верхнем уровне.
1. AudioMath: Определение Акустических Параметров через чистый DSP
Для определения BPM, Тональности (Key/Camelot) и проверки подлинности HiFi мы используем полосу AudioMath. Эта полоса работает совершенно независимо от моделей ONNX и опирается на классические алгоритмы DSP:
- Преимущество в производительности: она напрямую читает декодированный поток PCM аудиофайла, вычисляя всплески энергии и автокорреляцию на уровне Rust, что значительно экономит память.
- Определение настоящего/ложного HiFi: Чтобы обнаружить срезы высоких частот и фальшивый апсэмплинг, мы поддерживаем динамическую передачу частоты дискретизации на уровне предварительной обработки, непосредственно анализируя спектральный спад звука, чтобы избежать ошибок, возникающих при ресэмплинге.
2. MusicTags: Семантическая Классификация через ONNX
Для абстрактной семантики, такой как Жанр, Настроение и Инструменты, мы используем модели глубокого обучения, запускаемые локально. Результаты модели, обернутые в единую длительную задачу audio_analysis, точно сопоставляются с набором тегов пользователя.
[!NOTE]
Обе полосы строго придерживаются дизайна с нулевой зависимостью от сети, что гарантирует выполнение всего анализа медиа-активов на 100% на конечном устройстве (локально) с соблюдением исключительно высоких стандартов конфиденциальности.
II. Передовая Система Черновиков
Хотя модели ИИ мощны, они никогда не могут на 100% идеально соответствовать личным предпочтениям пользователя. Традиционные программы для управления музыкой часто напрямую перезаписывают метаданные звука после анализа, что весьма разрушительно для пользователей, бережно хранящих свои личные библиотеки.
Для решения этой проблемы мы внедрили Систему черновиков, основанную на SQLite, которая является одной из главных изюминок нашей архитектуры.
Основная логика Системы Черновиков заключается в том, что будь то ручное редактирование, анализ ИИ или пакетный импорт, никакие изменения не записываются напрямую в исходный аудиофайл. Сначала они генерируют цифровой План исправлений (Patch Plan), действующий как «черновик», который надежно хранится в независимой высокопроизводительной базе данных SQLite.
В рабочей области пользователи могут без проблем предварительно просматривать эффекты этих черновиков. Только когда пользователь полностью подтверждает и активно нажимает «Применить изменения», система использует атомарный конвейер безопасной записи (запись во временный файл, его замена и сохранение механизма отката через копию .bak) для окончательного закрепления этих тегов в файлах.
III. Практическое Применение Проверки Настоящего/Ложного HiFi
В DSP-полосе AudioMath проверка подлинности HiFi — это функция, которая в полной мере отражает гиковский дух нашего продукта.
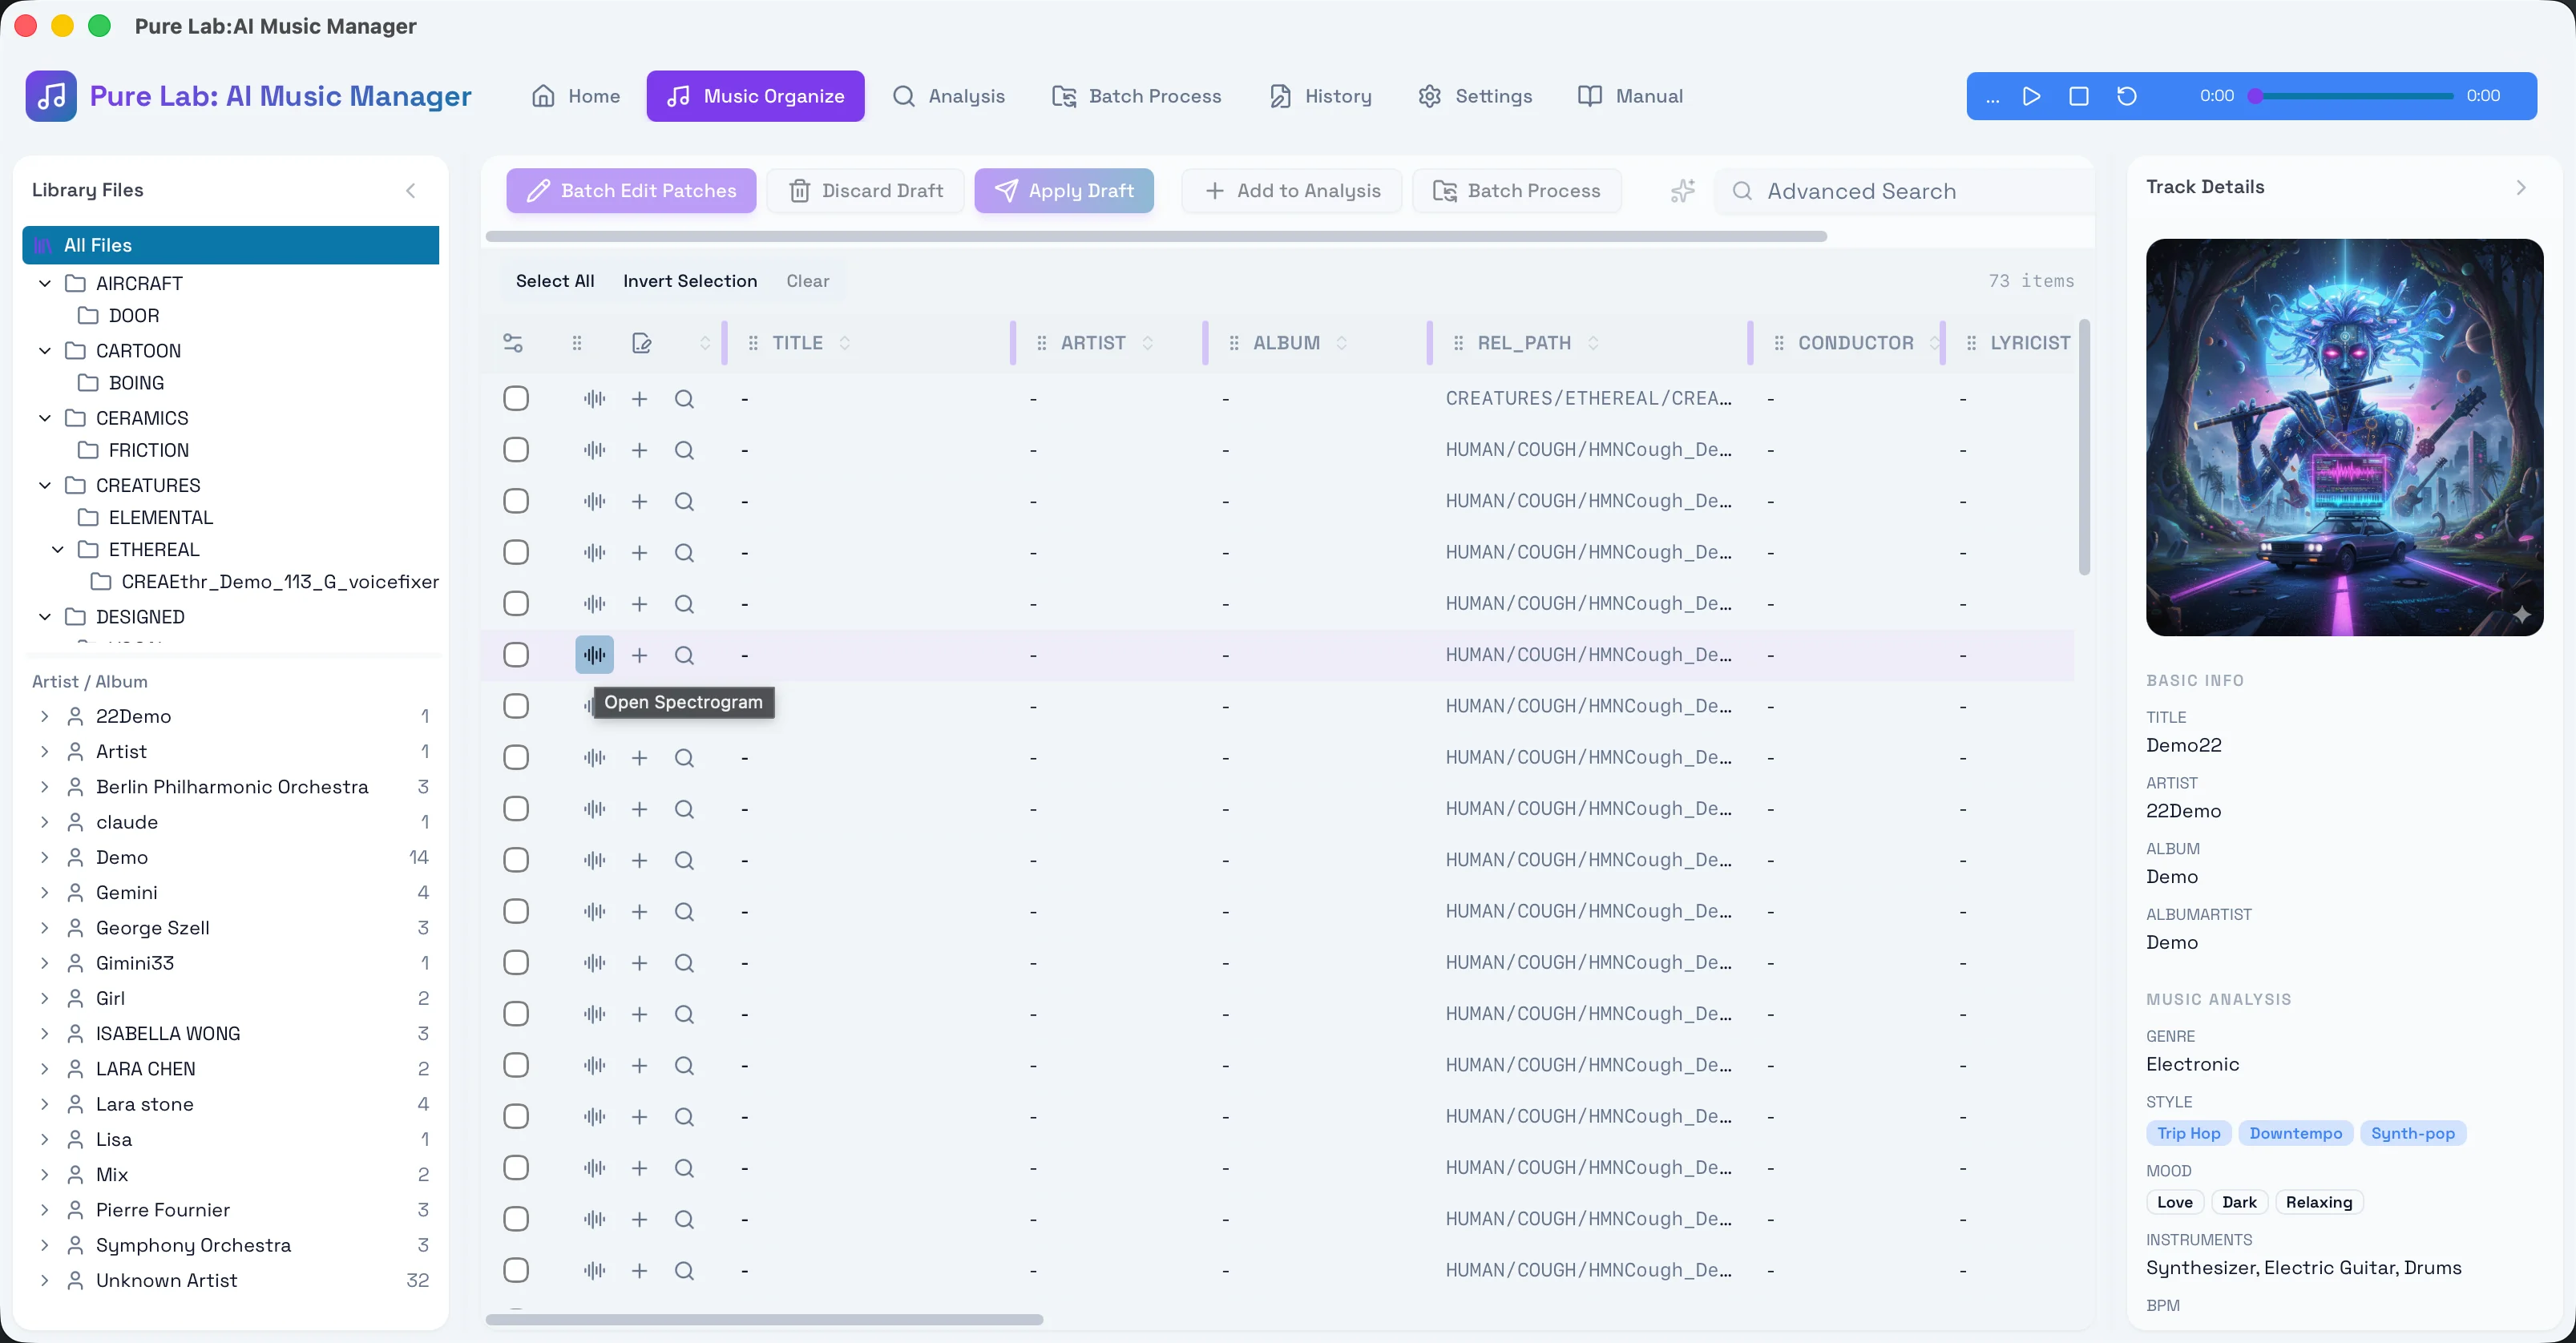
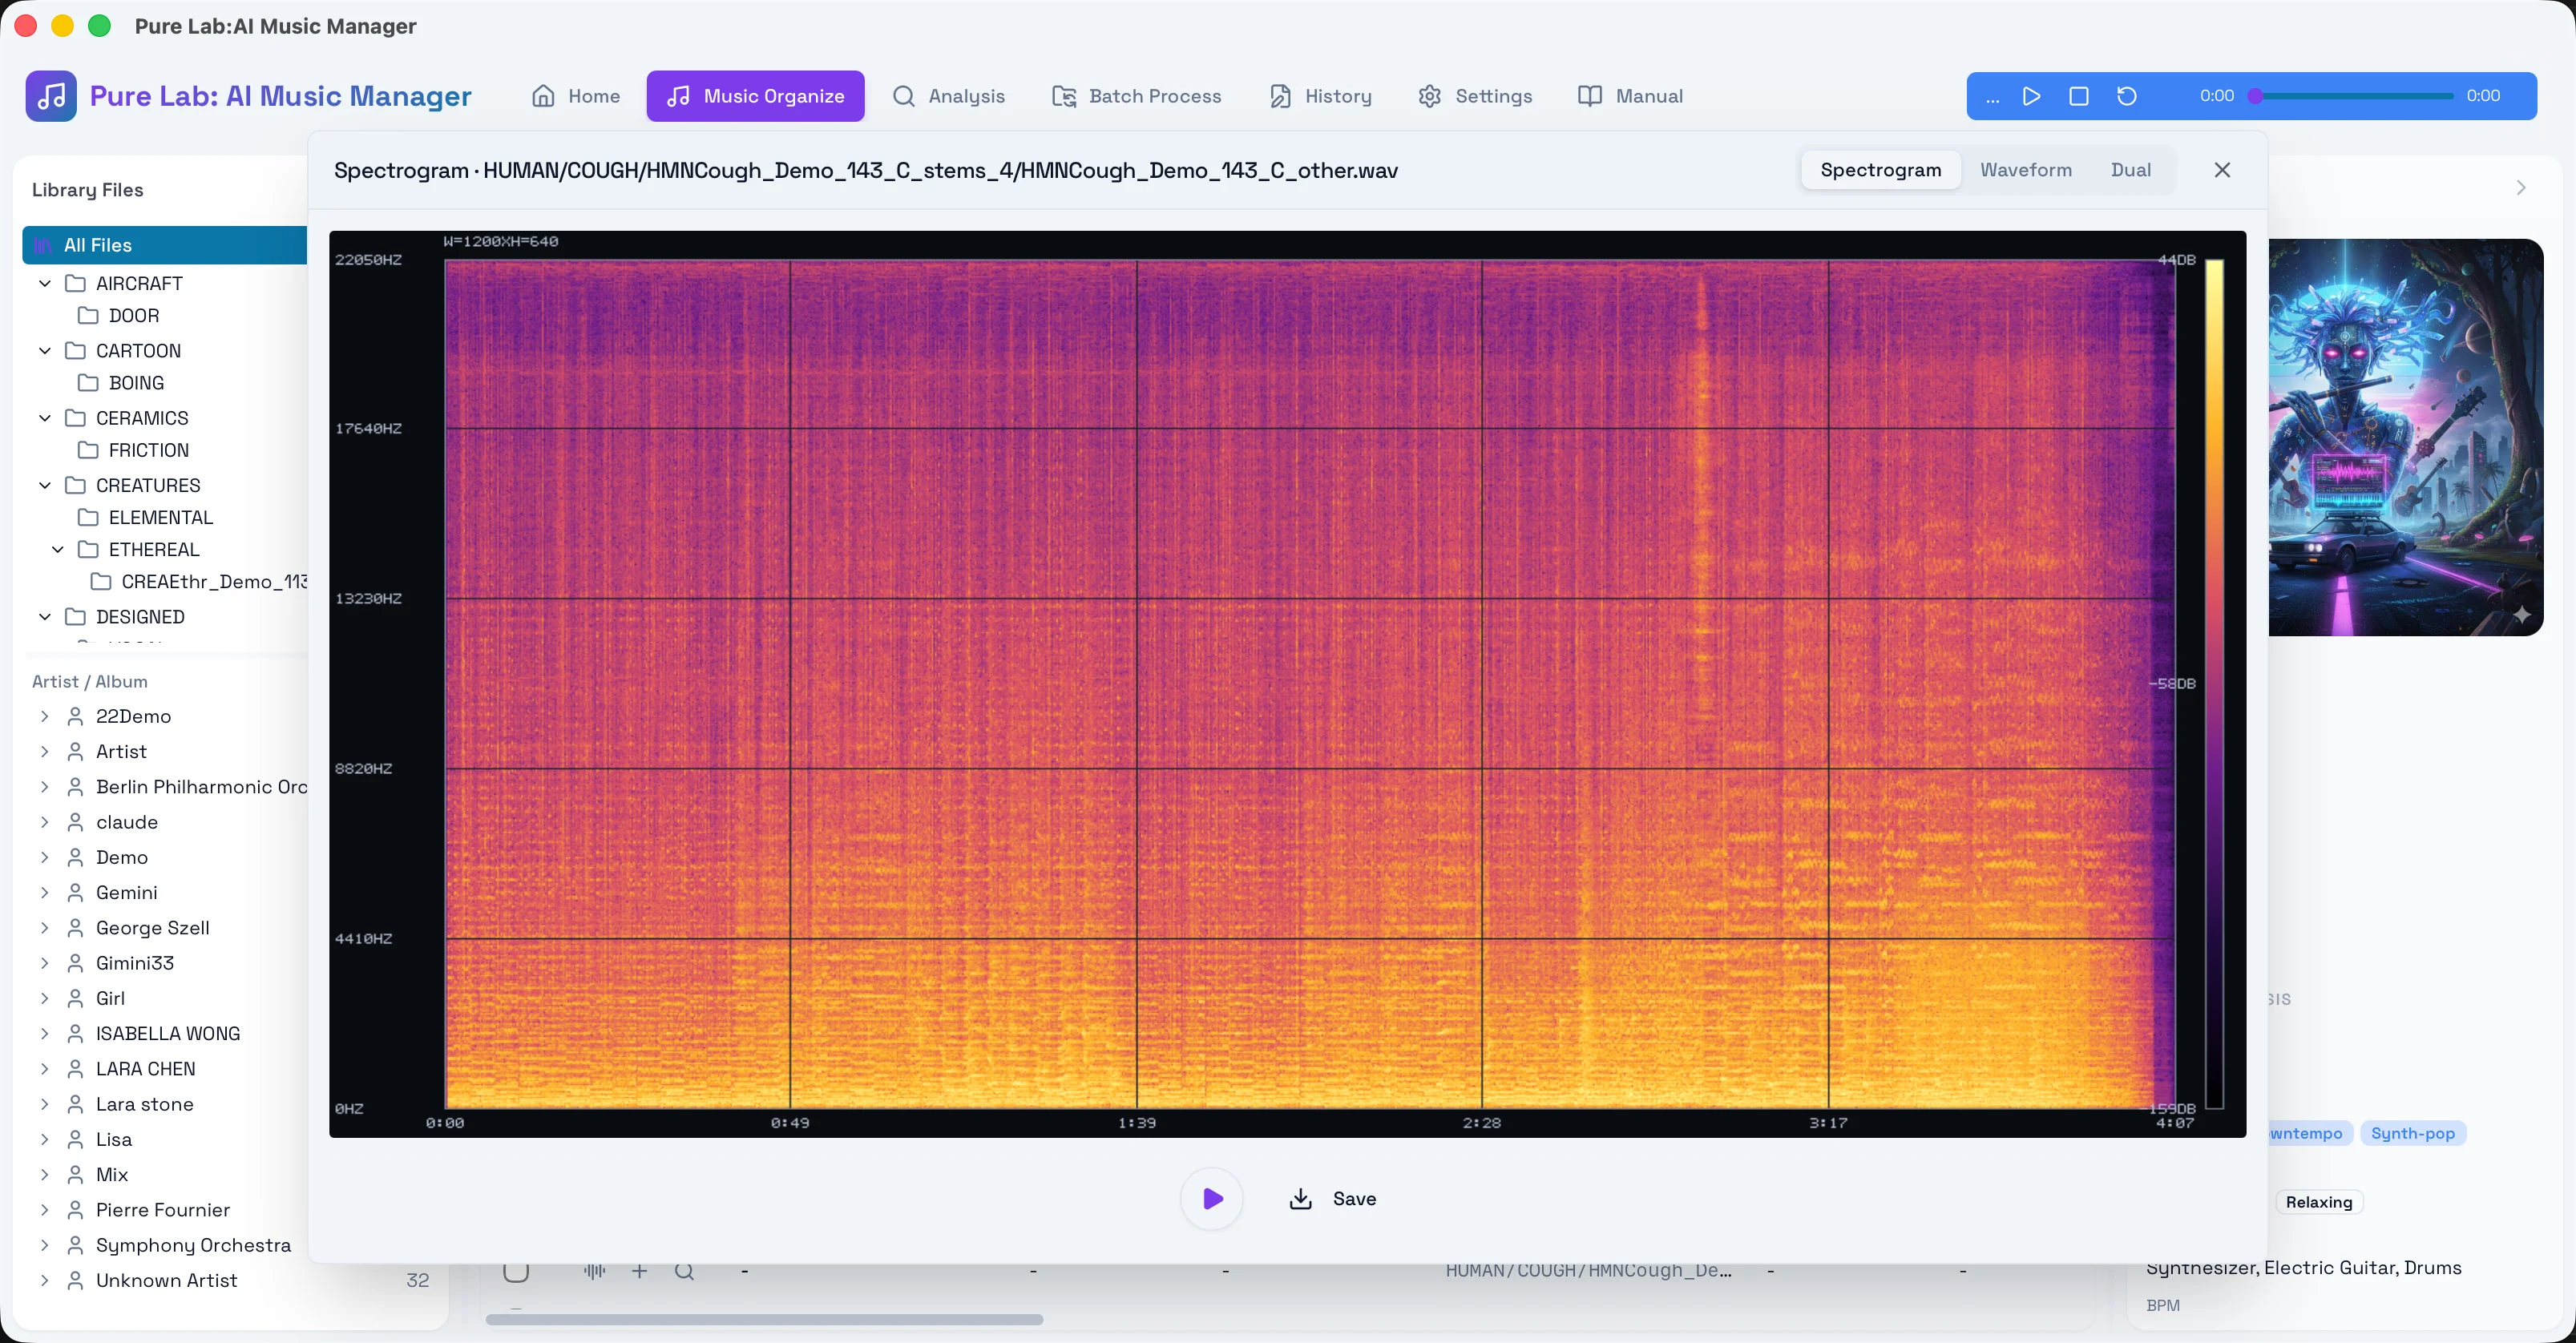
Как показано выше, при организации аудио, если вы сталкиваетесь с форматом высокого разрешения без потерь с меткой «24bit/192kHz», вы можете напрямую вызвать диалоговое окно спектрограммы. На нижнем уровне движка мы вычисляем PURE_QUALITY_CUTOFF_HZ и соответствующую оценку достоверности:
- TRUE_HIRES (Настоящий Hi-Res)
- SUSPICIOUS_UPSAMPLING (Подозрительный Апсэмплинг)
- SUSPICIOUS_LOSSY (Подозрительное Сжатие с потерями)
Чтобы избежать ошибочной оценки оригинальных DSD (шумоподавление на высоких частотах, характерное для форматов DFF/DSF, часто неверно оценивается традиционными алгоритмами), мы глубоко интегрировали этот процесс на этапе декодера, извлекая каскад спада энергии, соответствующий исходной частоте дискретизации PCM. Это позволяет системе интеллектуально и точно предотвращать проблемы еще до того, как пользователь решит записать теги.
Заключение
Через эти два основных канала AI Music Organizer обеспечивает локальную конфиденциальность данных, одновременно прокладывая путь к производительности и безопасности для анализа метаданных тегов. В следующих сериях технического анализа мы также углубимся в базовую поисковую систему и многоязычную семантическую архитектуру, так что следите за обновлениями.