Avec la croissance explosive des bibliothèques de musique numérique locales, l’analyse automatisée et intelligente des tags musicaux est devenue une nécessité pour les audiophiles et les organisateurs professionnels. Cependant, lors de l’introduction du marquage automatique par l’IA, nous avons été confrontés à un défi d’ingénierie majeur : Comment garantir la profondeur d’analyse ultime tout en s’assurant à 100 % que les précieux fichiers audio originaux de l’utilisateur ne soient pas contaminés ?
Dans la première phase de l’évolution de l’architecture, nous avons complètement résolu cette contradiction en découplant le Pipeline d’Analyse Audio et en introduisant un Système de Brouillons (Draft System) novateur.
I. Architecture à Deux Voies pour l’Analyse Audio
Pour équilibrer la précision de l’analyse, les performances et la disponibilité hors ligne, nous avons découplé les tâches d’analyse de la couche inférieure en deux voies indépendantes : Traitement Numérique du Signal (DSP) pur et Inférence Deep Learning (ONNX), tout en maintenant un flux d’événements et d’états unifié au niveau de la couche supérieure.
1. AudioMath : Détection des Paramètres Acoustiques via DSP Pur
Pour détecter les BPM, la Tonalité (Key/Camelot) et authentifier le Vrai/Faux HiFi, nous utilisons la voie AudioMath. Cette voie fonctionne de manière totalement indépendante des modèles ONNX et s’appuie sur des algorithmes DSP classiques :
- Avantage de Performance : Il lit directement le flux PCM décodé du fichier audio, en calculant les pics d’énergie et l’autocorrélation dans la couche Rust, ce qui économise énormément de mémoire.
- Authentification Vrai/Faux HiFi : Pour détecter les coupures de hautes fréquences et le faux suréchantillonnage, nous prenons en charge le passthrough dynamique du taux d’échantillonnage au niveau de la couche de prétraitement, en analysant directement la décroissance spectrale de l’audio pour éviter les erreurs introduites par le rééchantillonnage.
2. MusicTags : Classification Sémantique via ONNX
Pour la sémantique abstraite comme le Genre, l’Ambiance et les Instruments, nous utilisons des modèles de deep learning exécutés localement. Enveloppées dans une tâche longue unifiée audio_analysis, les sorties du modèle sont précisément cartographiées vers l’ensemble de tags de l’utilisateur.
[!NOTE]
Les deux voies adhèrent strictement à une conception à zéro dépendance réseau, garantissant que toute l’analyse des actifs multimédias est effectuée à 100 % sur l’appareil (localement), répondant à des normes de confidentialité extrêmement élevées.
II. Le Système de Brouillons Novateur
Bien que les modèles d’IA soient puissants, ils ne peuvent jamais correspondre parfaitement aux préférences personnelles d’un utilisateur dans 100 % des cas. Les logiciels de gestion musicale traditionnels écrasent souvent directement les métadonnées audio après analyse, ce qui est très destructeur pour les utilisateurs qui gèrent soigneusement leurs bibliothèques personnelles.
Pour remédier à cela, nous avons introduit le Système de Brouillons basé sur SQLite, qui est l’un des points forts fondamentaux de notre architecture.
La logique fondamentale du Système de Brouillons est que qu’il s’agisse d’une édition manuelle, d’une analyse par IA ou d’importations par lots, aucune modification n’est directement écrite dans le fichier audio d’origine. Ils génèrent d’abord un Plan de Patch numérique, agissant comme un “brouillon” stocké en toute sécurité dans une base de données SQLite indépendante et performante.
Au sein de l’espace de travail, les utilisateurs peuvent prévisualiser en toute transparence les effets de ces brouillons. Ce n’est que lorsque l’utilisateur confirme totalement et clique activement sur “Appliquer les modifs” que le système utilise un pipeline d’écriture sécurisé atomique (écriture dans un fichier temporaire, remplacement et maintien d’un mécanisme d’annulation via une copie .bak) pour consolider ces tags dans les fichiers.
III. Application Pratique de l’Authentification Vrai/Faux HiFi
Dans la voie DSP AudioMath, l’authentification Vrai/Faux HiFi est une fonctionnalité qui illustre parfaitement l’esprit geek de notre produit.
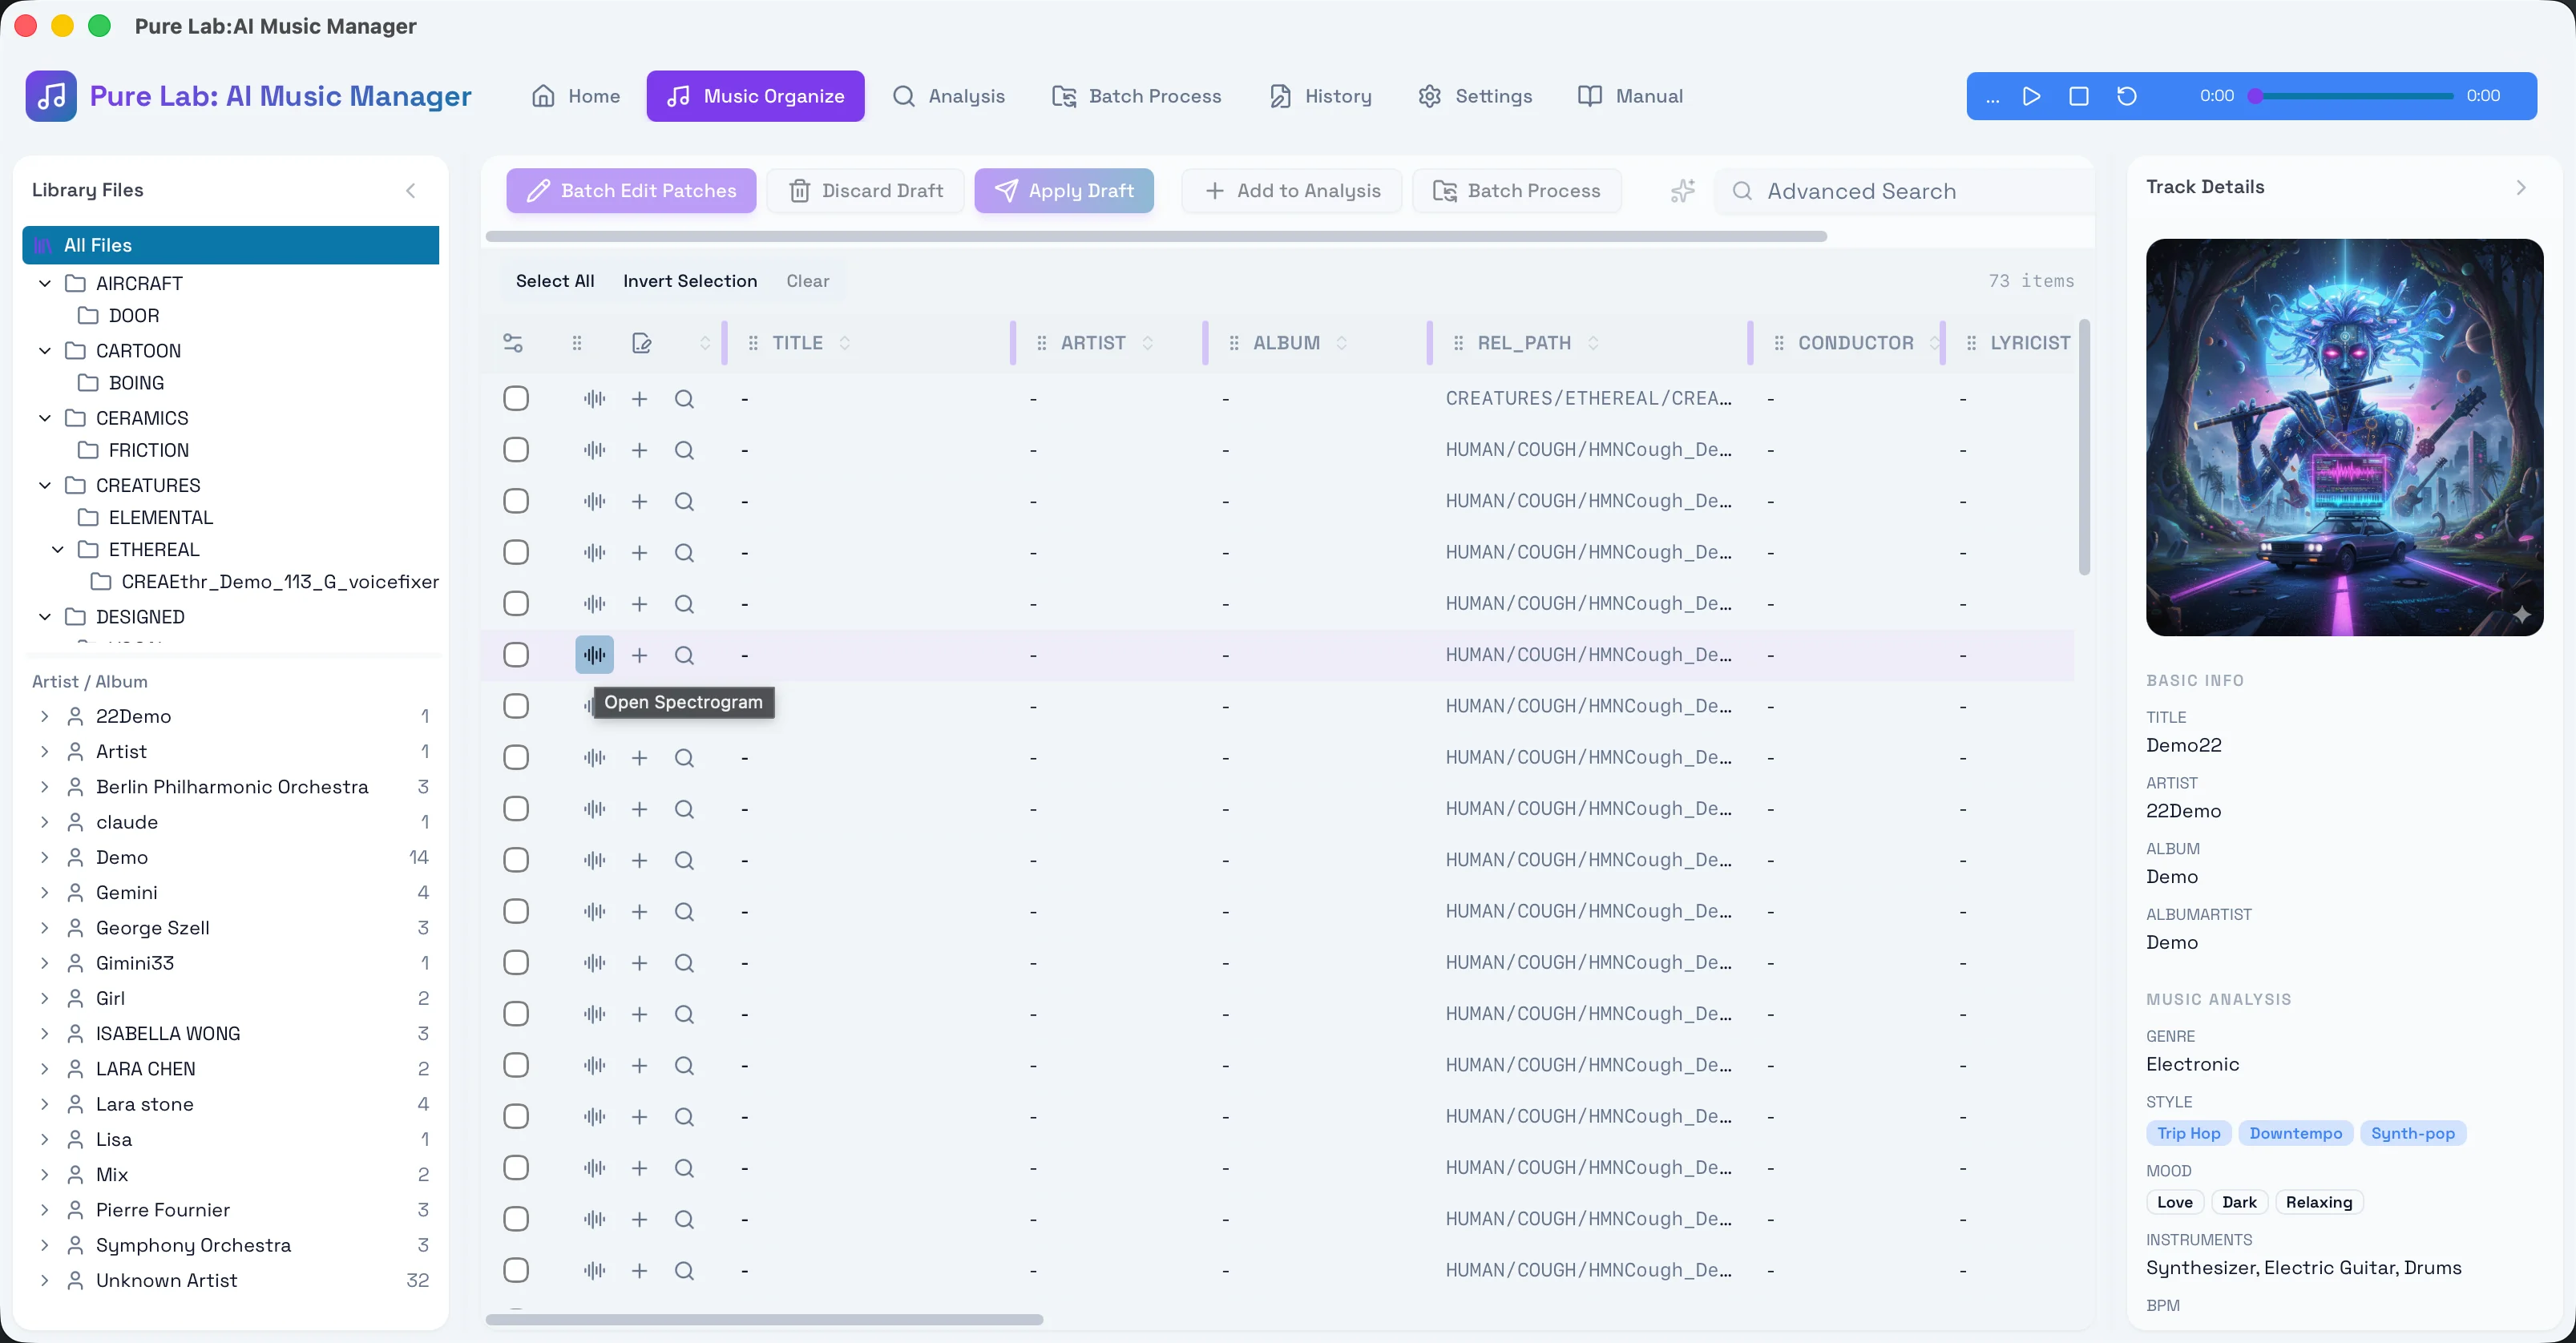
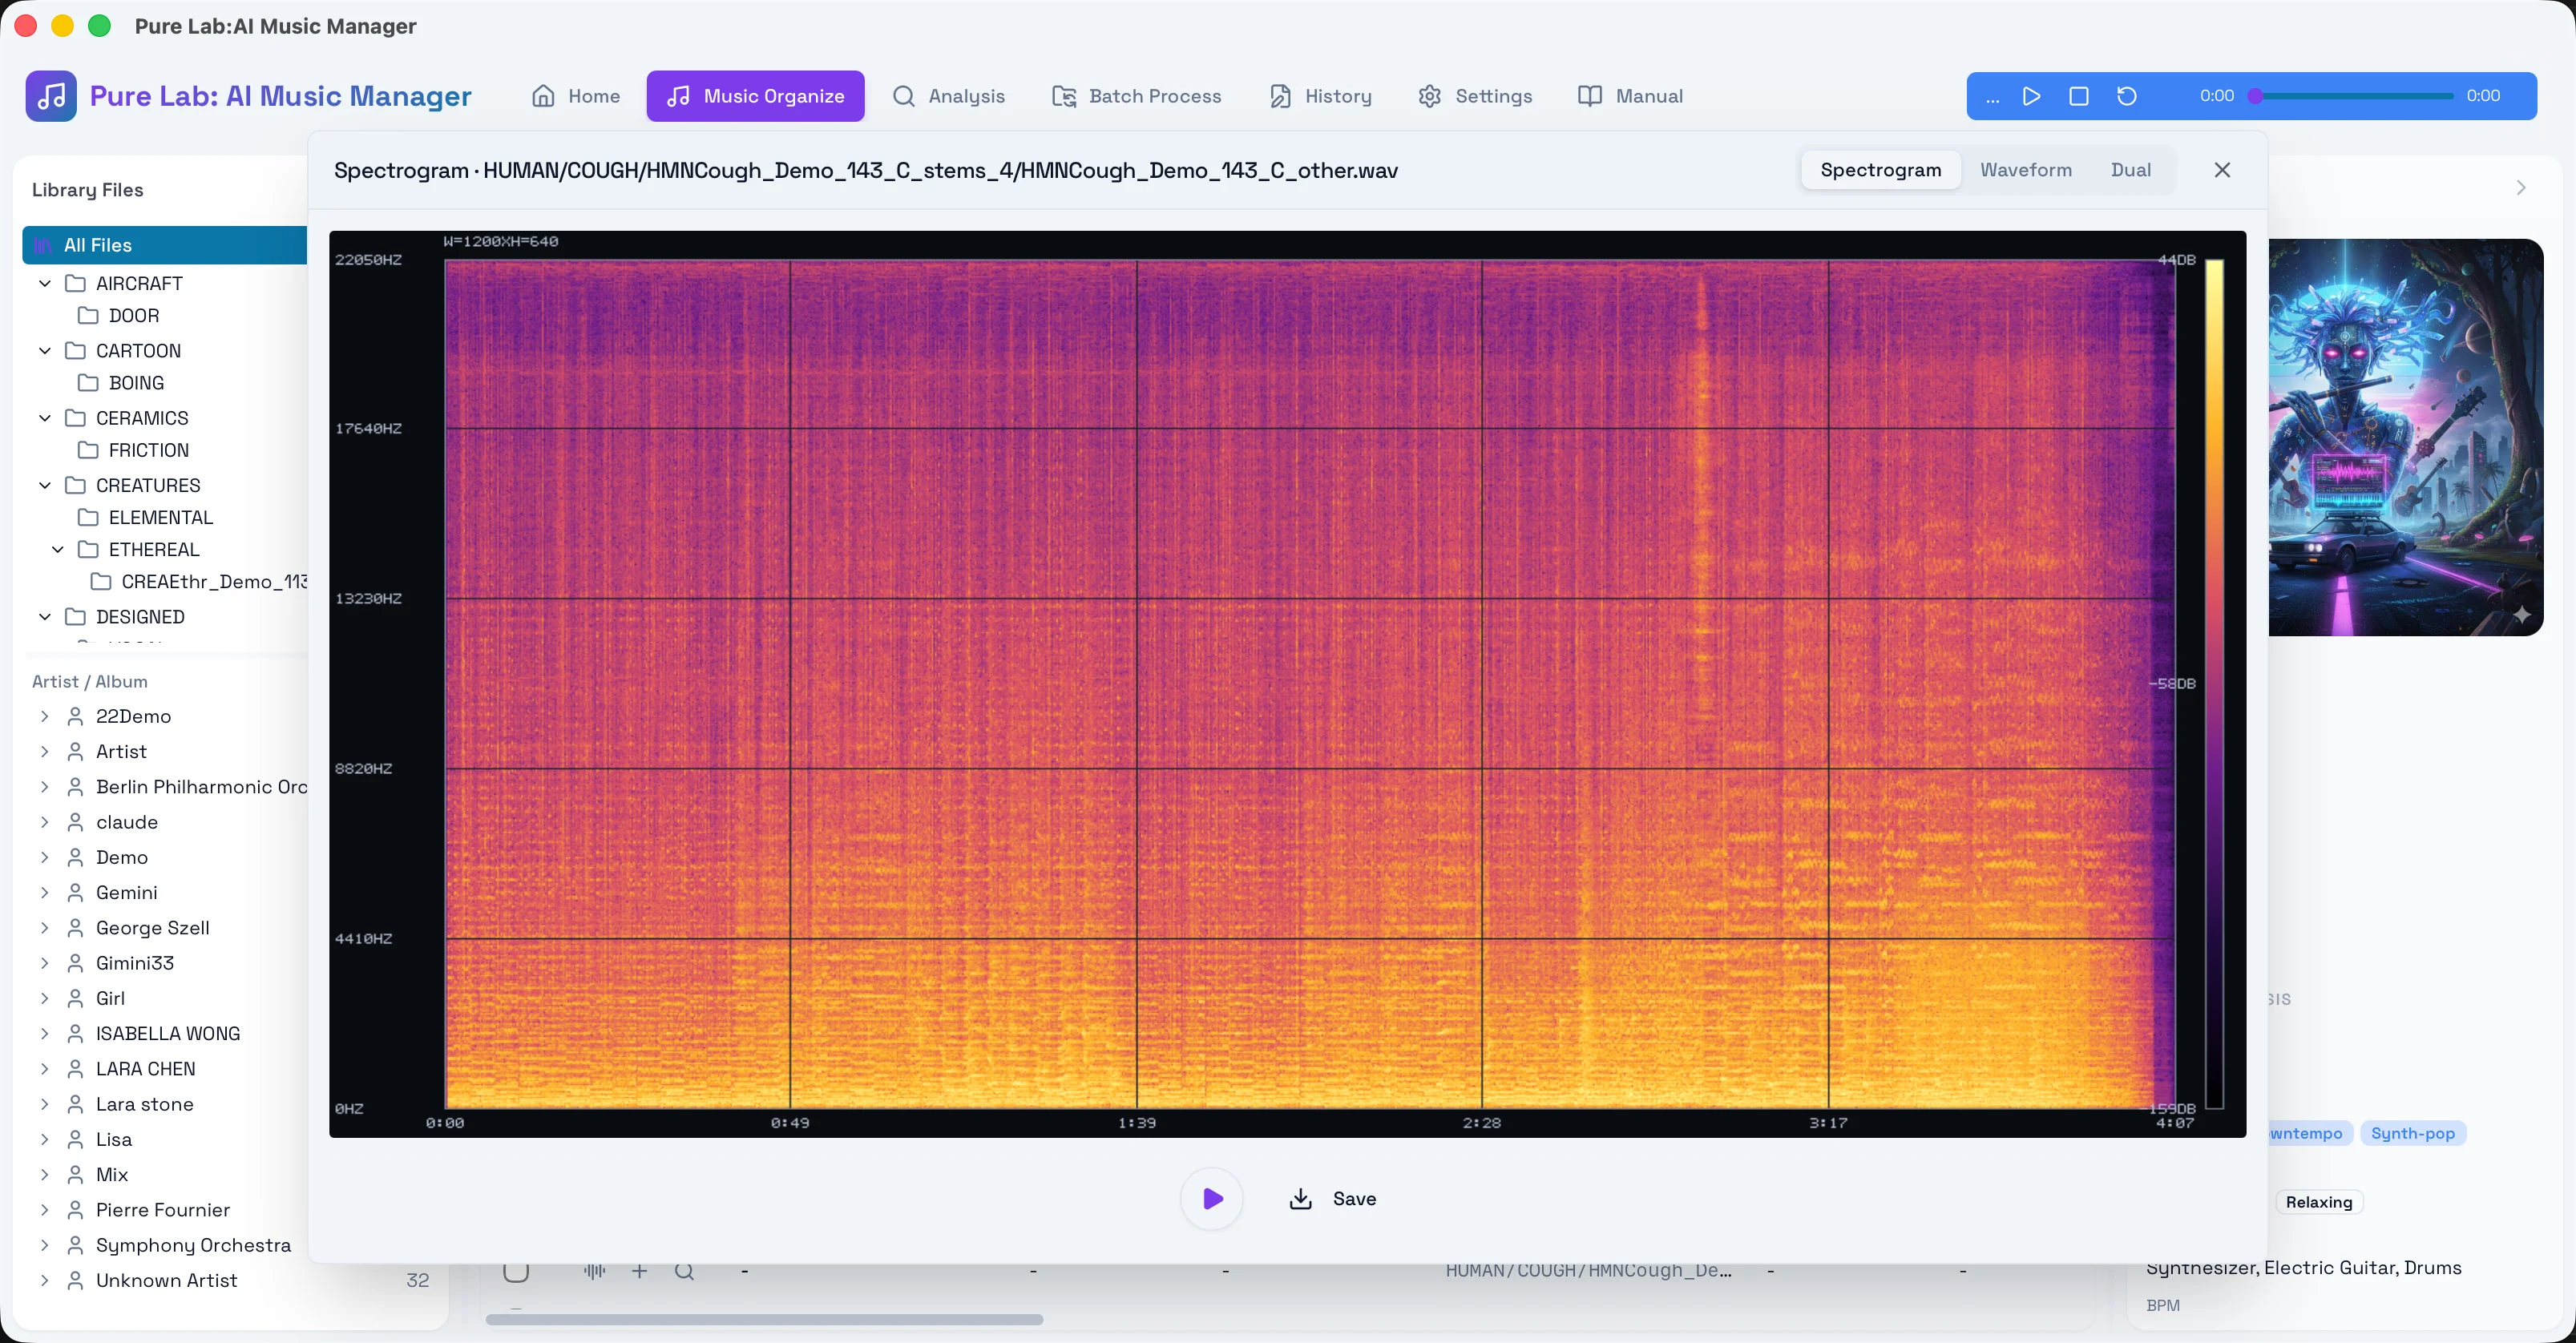
Comme illustré ci-dessus, lors de l’organisation de l’audio, si vous rencontrez un format haute résolution sans perte étiqueté “24bit/192kHz”, vous pouvez directement afficher la boîte de dialogue du spectrogramme. Dans la couche inférieure du moteur, nous calculons la valeur PURE_QUALITY_CUTOFF_HZ et le score de confiance correspondant :
- TRUE_HIRES (Véritable Hi-Res)
- SUSPICIOUS_UPSAMPLING (Suréchantillonnage Suspect)
- SUSPICIOUS_LOSSY (Compression avec perte suspecte)
Pour éviter de mal juger les DSD originaux (la mise en forme du bruit à haute fréquence induite par les formats DFF/DSF est souvent mal jugée par les algorithmes traditionnels), nous avons profondément intégré ce processus dans l’étape du décodeur, en extrayant la cascade de décroissance d’énergie correspondant à la fréquence d’échantillonnage PCM native. Cela permet au système de prévenir intelligemment et précisément les problèmes avant que l’utilisateur ne décide d’écrire les tags.
Conclusion
Grâce à ces deux canaux principaux, AI Music Organizer garantit la confidentialité des données locales tout en ouvrant la voie en matière de performances et de sécurité pour l’analyse des métadonnées de tags. Dans nos prochaines séries d’analyses techniques, nous plongerons également dans le moteur de recherche sous-jacent et l’architecture sémantique multilingue, alors restez à l’écoute.