Com o crescimento explosivo das bibliotecas locais de música digital, a análise automatizada e inteligente de tags de música tornou-se uma necessidade para audiófilos e organizadores profissionais. No entanto, ao introduzir a marcação automática com IA, enfrentamos um sério desafio de engenharia: Como garantir a profundidade máxima de análise, garantindo 100% que os preciosos arquivos de áudio originais do usuário não sejam contaminados?
Na primeira fase da evolução da arquitetura, resolvemos completamente essa contradição dissociando o Pipeline de Análise de Áudio e introduzindo um Sistema de Rascunhos pioneiro.
I. Arquitetura de Pista Dupla para Análise de Áudio
Para equilibrar a precisão da análise, o desempenho e a disponibilidade offline, separamos as tarefas de análise na camada inferior em duas pistas independentes: Processamento de Sinal Digital (DSP) puro e Inferência de Deep Learning (ONNX), mantendo um fluxo unificado de eventos e estados na camada superior.
1. AudioMath: Detecção de Parâmetros Acústicos via DSP Puro
Para detecção de BPM, Tom (Key/Camelot) e autenticação de HiFi verdadeiro/falso, utilizamos a pista AudioMath. Esta pista opera de forma totalmente independente dos modelos ONNX e baseia-se em algoritmos DSP clássicos:
- Vantagem de Desempenho: Ele lê diretamente o fluxo PCM decodificado do arquivo de áudio, calculando picos de energia e autocorrelação na camada Rust, economizando muita memória.
- Autenticação HiFi Verdadeiro/Falso: Para detectar cortes de alta frequência e falsos upsamplings, suportamos o repasse dinâmico da taxa de amostragem na camada de pré-processamento, analisando diretamente a degradação espectral do áudio para evitar erros introduzidos pela reamostragem.
2. MusicTags: Classificação Semântica via ONNX
Para semântica abstrata como Gênero, Humor e Instrumentos, usamos modelos de deep learning executados localmente. Agrupadas em uma tarefa contínua e unificada de audio_analysis, as saídas do modelo são mapeadas com precisão para o conjunto de tags do usuário.
[!NOTE]
Ambas as pistas seguem estritamente um design de dependência de rede zero, garantindo que todas as análises de mídia sejam concluídas 100% no dispositivo (localmente), atendendo a padrões de privacidade extremamente altos.
II. O Sistema Pioneiro de Rascunhos
Embora os modelos de IA sejam poderosos, eles nunca podem corresponder perfeitamente às preferências pessoais de um usuário 100% das vezes. Tradicionalmente, os softwares de gerenciamento de música muitas vezes sobrescrevem diretamente os metadados de áudio após a análise, o que é altamente destrutivo para usuários que gerenciam cuidadosamente suas bibliotecas pessoais.
Para resolver isso, introduzimos o Sistema de Rascunhos baseado em SQLite, que é um dos principais destaques de nossa arquitetura.
A lógica principal do Sistema de Rascunhos é que seja por meio de edição manual, análise de IA ou importações em lote, nenhuma modificação é gravada diretamente no arquivo de áudio original. Eles primeiro geram um Plano de Patch digital, agindo como um “rascunho” armazenado com segurança em um banco de dados SQLite independente de alto desempenho.
Dentro do espaço de trabalho, os usuários podem pré-visualizar os efeitos desses rascunhos sem problemas. Somente quando o usuário confirma totalmente e clica ativamente em “Aplicar Alterações”, o sistema usa um pipeline de gravação atômico e seguro (gravando em um arquivo temporário, substituindo-o e retendo um mecanismo de reversão por meio de uma cópia .bak) para consolidar essas tags nos arquivos.
III. Aplicação Prática da Autenticação de HiFi Verdadeiro/Falso
Na pista AudioMath DSP, a autenticação de HiFi Verdadeiro/Falso é um recurso que exemplifica amplamente o espírito geek do nosso produto.
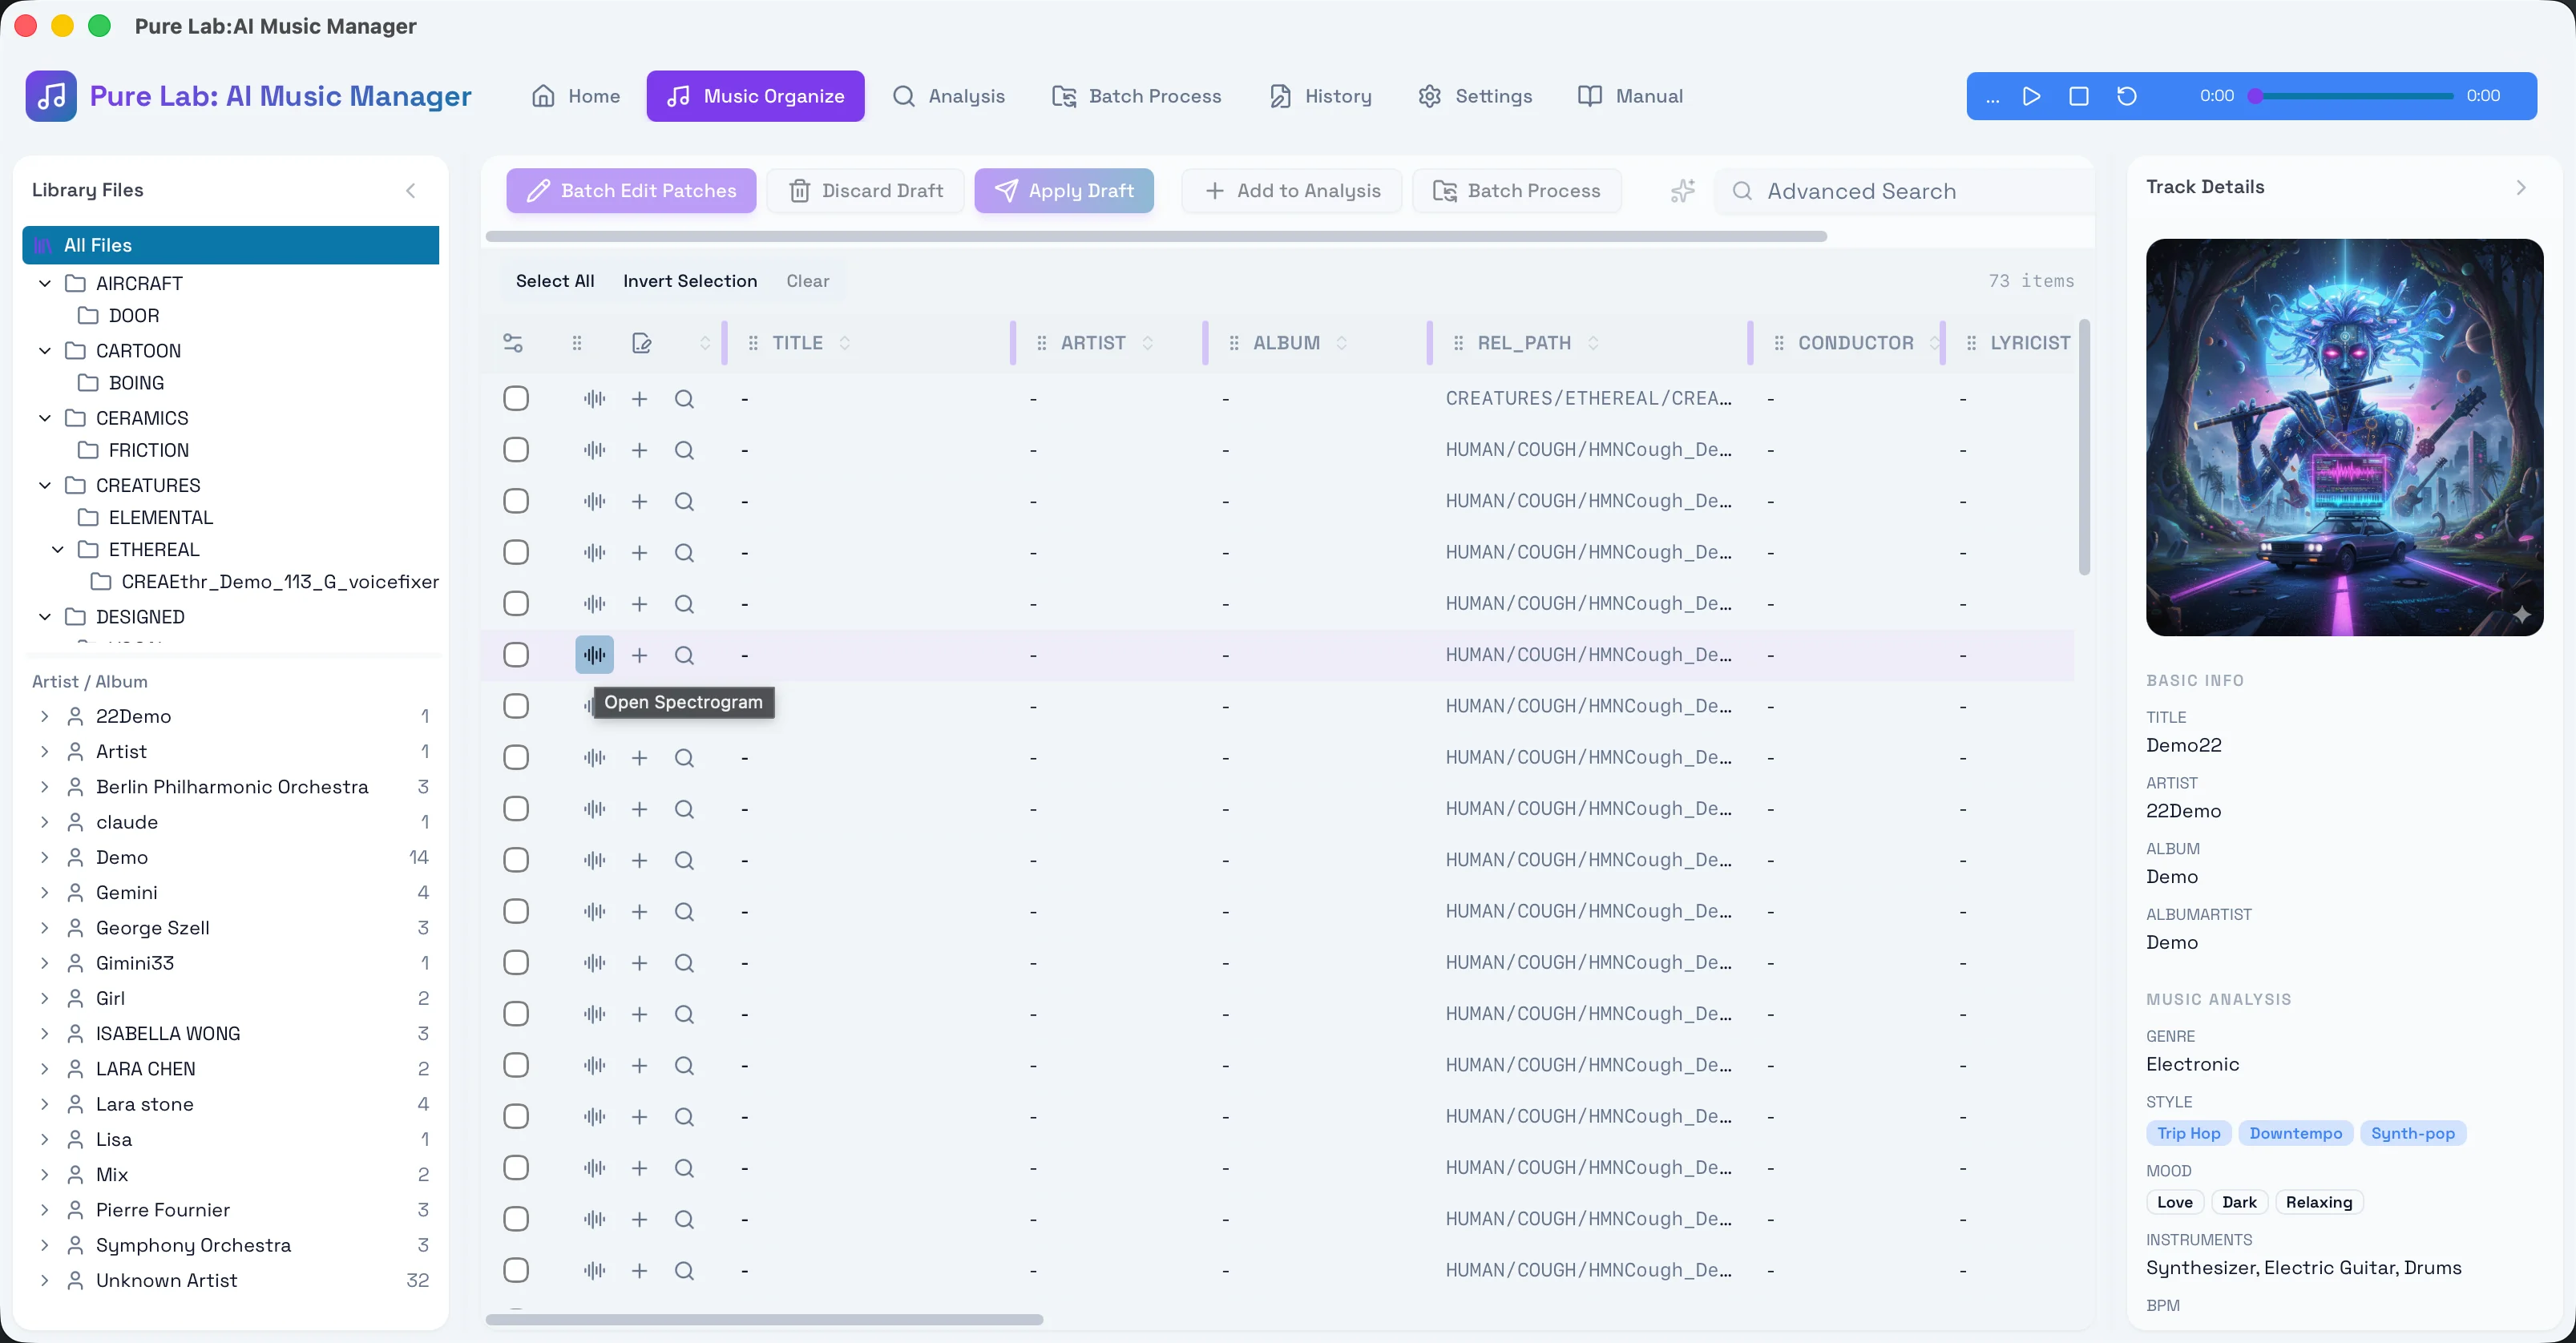
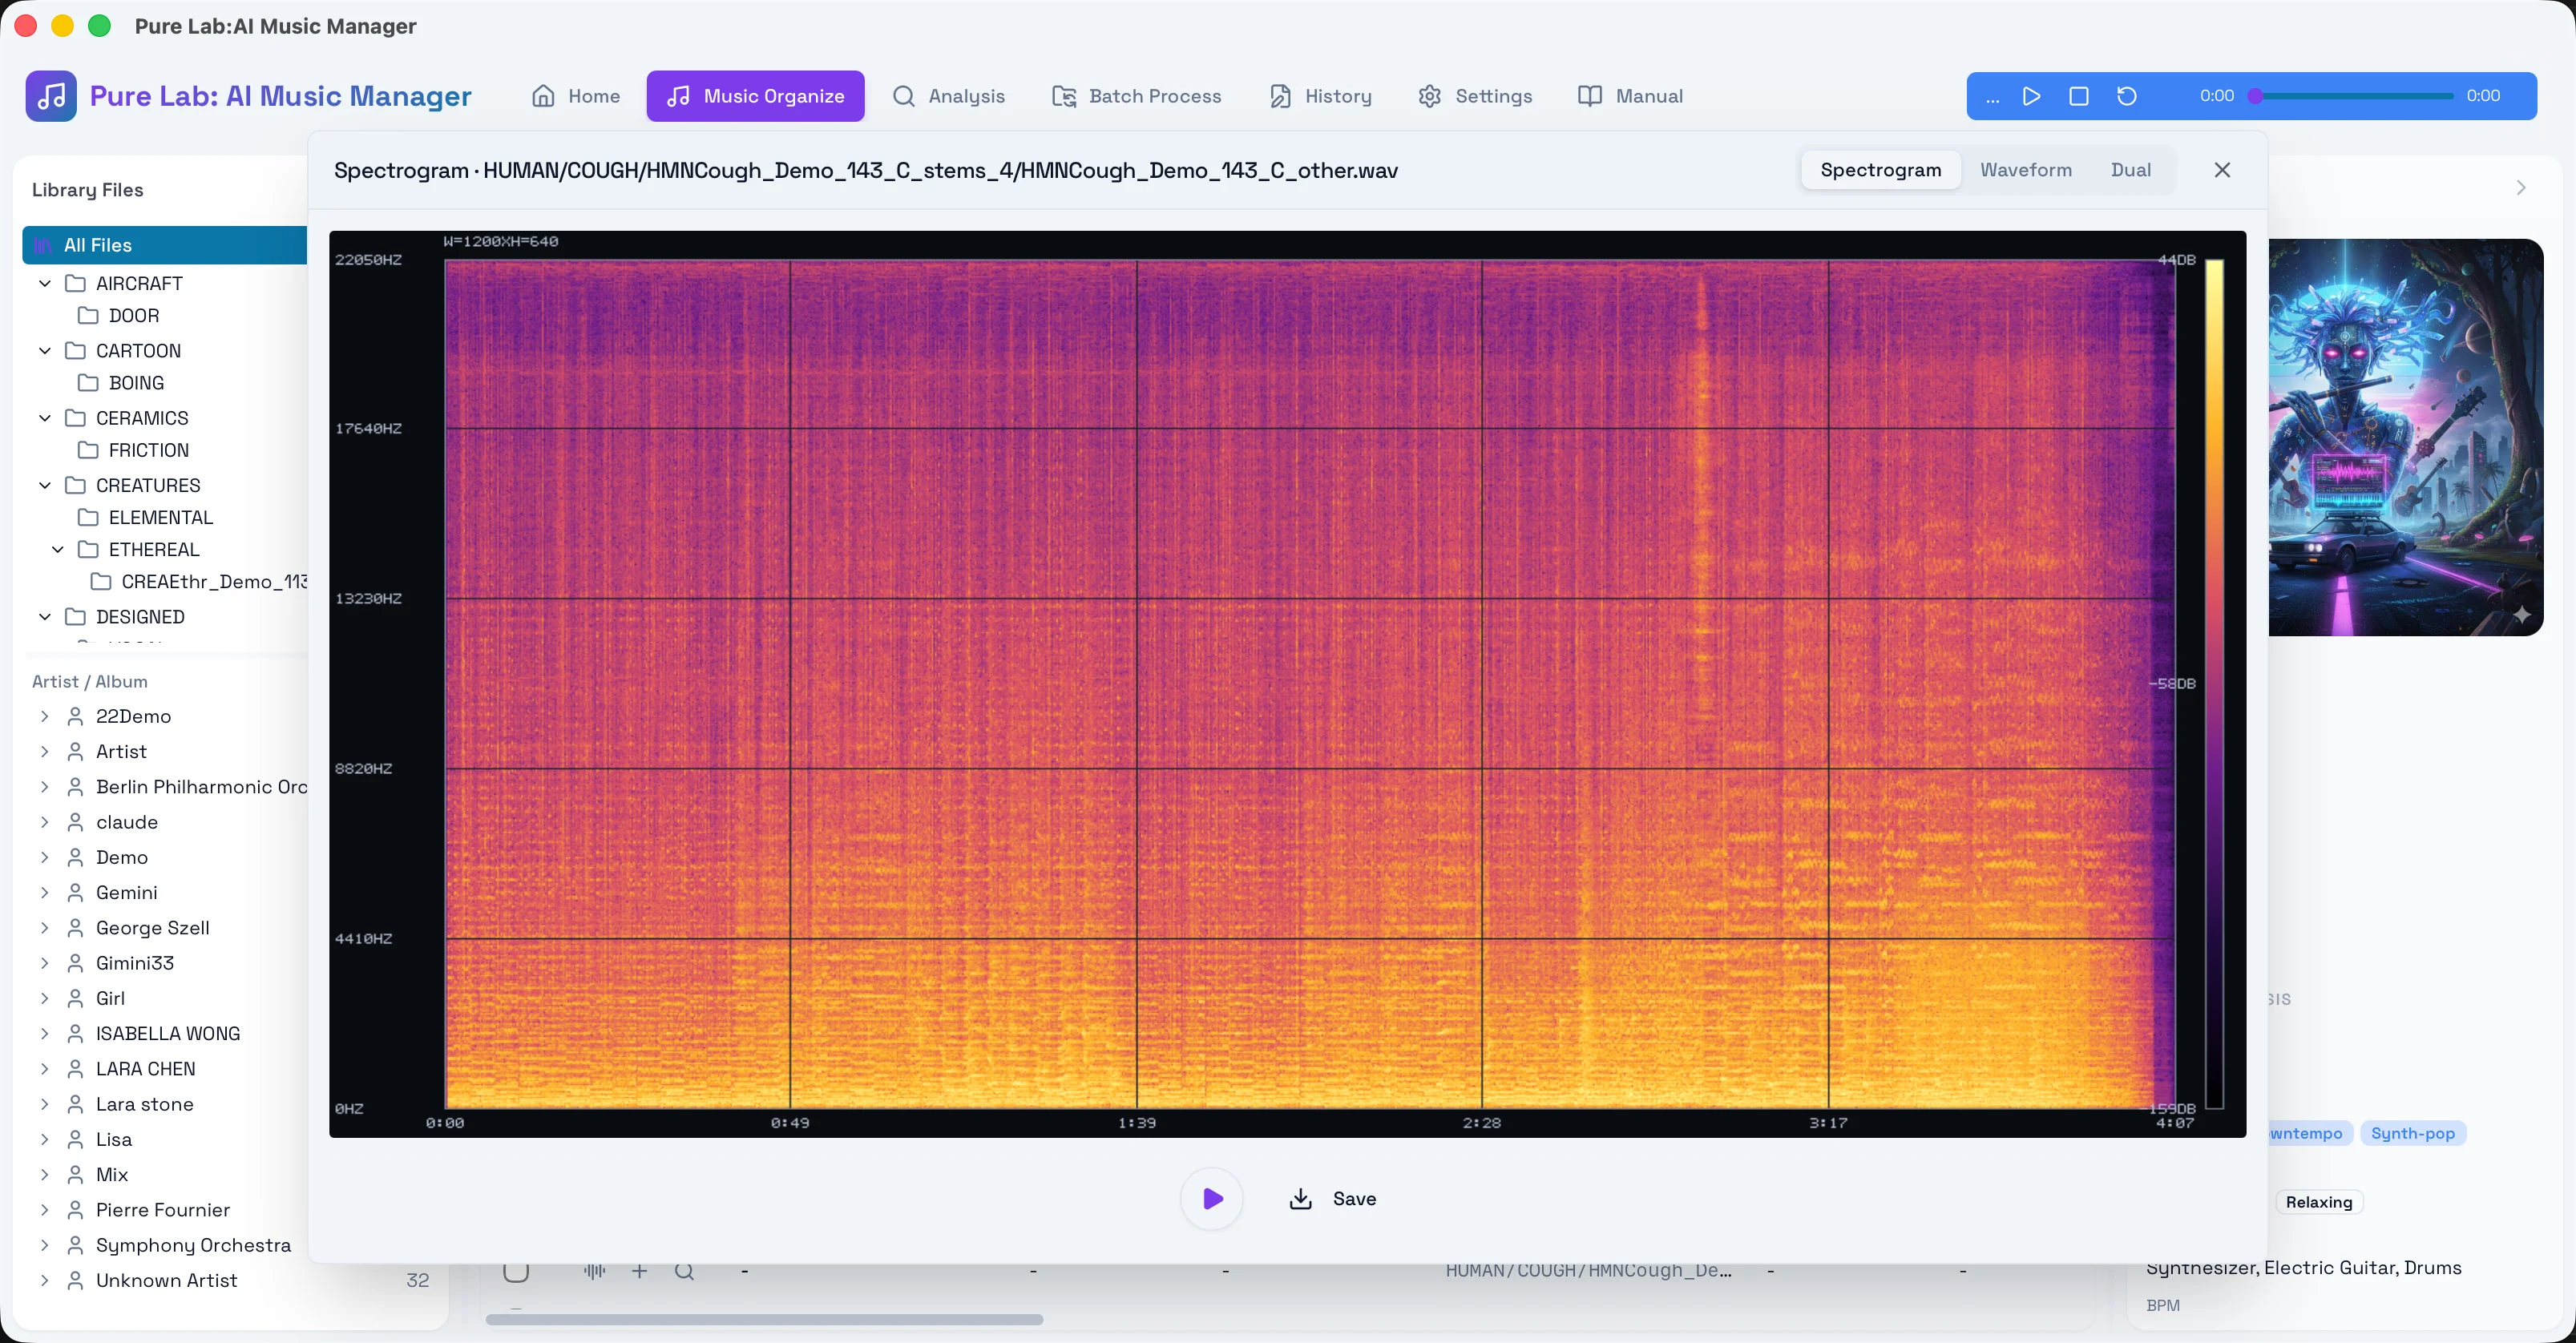
Conforme mostrado acima, ao organizar o áudio, se você encontrar um formato sem perdas de alta resolução rotulado como “24bit/192kHz”, você pode abrir diretamente o diálogo do espectrograma. Na camada inferior do motor, calculamos o PURE_QUALITY_CUTOFF_HZ e a pontuação de confiança correspondente:
- TRUE_HIRES (HiRes Genuíno)
- SUSPICIOUS_UPSAMPLING (Upsampling Suspeito)
- SUSPICIOUS_LOSSY (Perda Suspeita)
Para evitar o julgamento incorreto de DSDs originais (a modelagem de ruído de alta frequência trazida pelos formatos DFF/DSF é frequentemente mal interpretada por algoritmos tradicionais), integramos esse processo profundamente no estágio de decodificador, extraindo a cascata de decaimento de energia correspondente à taxa de amostragem PCM nativa. Isso permite que o sistema evite problemas de maneira inteligente e precisa antes que o usuário decida gravar as tags.
Conclusão
Por meio desses dois canais principais, o AI Music Organizer garante a privacidade dos dados locais enquanto é pioneiro em um caminho de desempenho e segurança para a análise de metadados de tags. Nas próximas séries de análise técnica, também vamos nos aprofundar no mecanismo de busca subjacente e na arquitetura semântica multilíngue, então fiquem ligados.