随着本地数字音乐库规模的爆发式增长,自动化、智能化的音乐标签分析逐渐成为了发烧友与专业整理者的刚需。然而,在引入 AI 自动化标注时,我们面临着一个严峻的工程挑战:如何在保证极致分析深度的同时,100% 确保用户原有的珍贵音频文件不被污染?
在第一阶段的架构演进中,我们通过解耦 音频分析管道 (Audio Analysis Pipeline) 与首创的 草稿系统 (Draft System) 彻底解决了这一矛盾。
一、音频分析的双路架构
为了平衡分析的准确率、性能以及离线可用性,我们在底层将分析任务解耦为纯数字信号处理(DSP)与深度学习推理(ONNX)两条独立链路,但在上层保持了统一的事件与状态流。
1. AudioMath:纯 DSP 的声学参数探测
针对 BPM、调性(Key/Camelot)以及真假 HiFi 探测,我们采用 AudioMath 链路。该链路完全不依赖 ONNX 模型,而是采用经典的 DSP 算法:
- 性能优势:直接读取音频文件解码后的 PCM 流,在 Rust 层计算能量突变与自相关性,极大地节省了内存。
- 真假 HiFi 溯源:针对高频截断与上采样造假,我们在预处理层支持动态采样率透传,直接分析音频的频谱衰减,避免二次采样引入误差。
2. MusicTags:基于 ONNX 的语义分类
针对流派(Genre)、情绪(Mood)和乐器(Instruments)等抽象语义,我们采用本地运行的深度学习模型。通过统一的 audio_analysis 长任务包装,模型输出将被精准映射为用户的标签集。
[!NOTE]
这两条链路都遵循着无网络依赖的严格设计,确保用户的所有媒体资产分析 100% 在端侧完成,满足极高标准的隐私要求。
二、首创草稿系统 (Draft System)
AI 模型虽然强大,但永远不可能做到 100% 契合用户的个人偏好。传统的音乐管理软件往往在分析完成后直接覆写音频元数据(Metadata),这对于精心维护个人库的用户来说是极具破坏性的。
为此,我们引入了基于 SQLite 的 草稿系统,这也是我们架构的核心亮点之一。
草稿系统的核心逻辑在于:无论是手动编辑、AI 分析还是批量导入,所有的修改都不会直接写回原音频文件。它们会首先生成一份数字补丁 (Patch Plan),作为“草稿”安全地存放在独立的高性能 SQLite 数据库中。
在工作台中,用户可以无缝预览这些草稿的效果。只有在用户完全确认无误,并主动点击“应用写回”时,系统才会通过原子级的安全写入链路(先写入临时文件,替换后再通过 .bak 副本保留回滚机制),将这些标签真切地固化到文件中。
三、真假 HiFi 探测的实战应用
在 AudioMath DSP 链路中,真假 HiFi 探测是一个非常能体现我们产品极客精神的功能点。
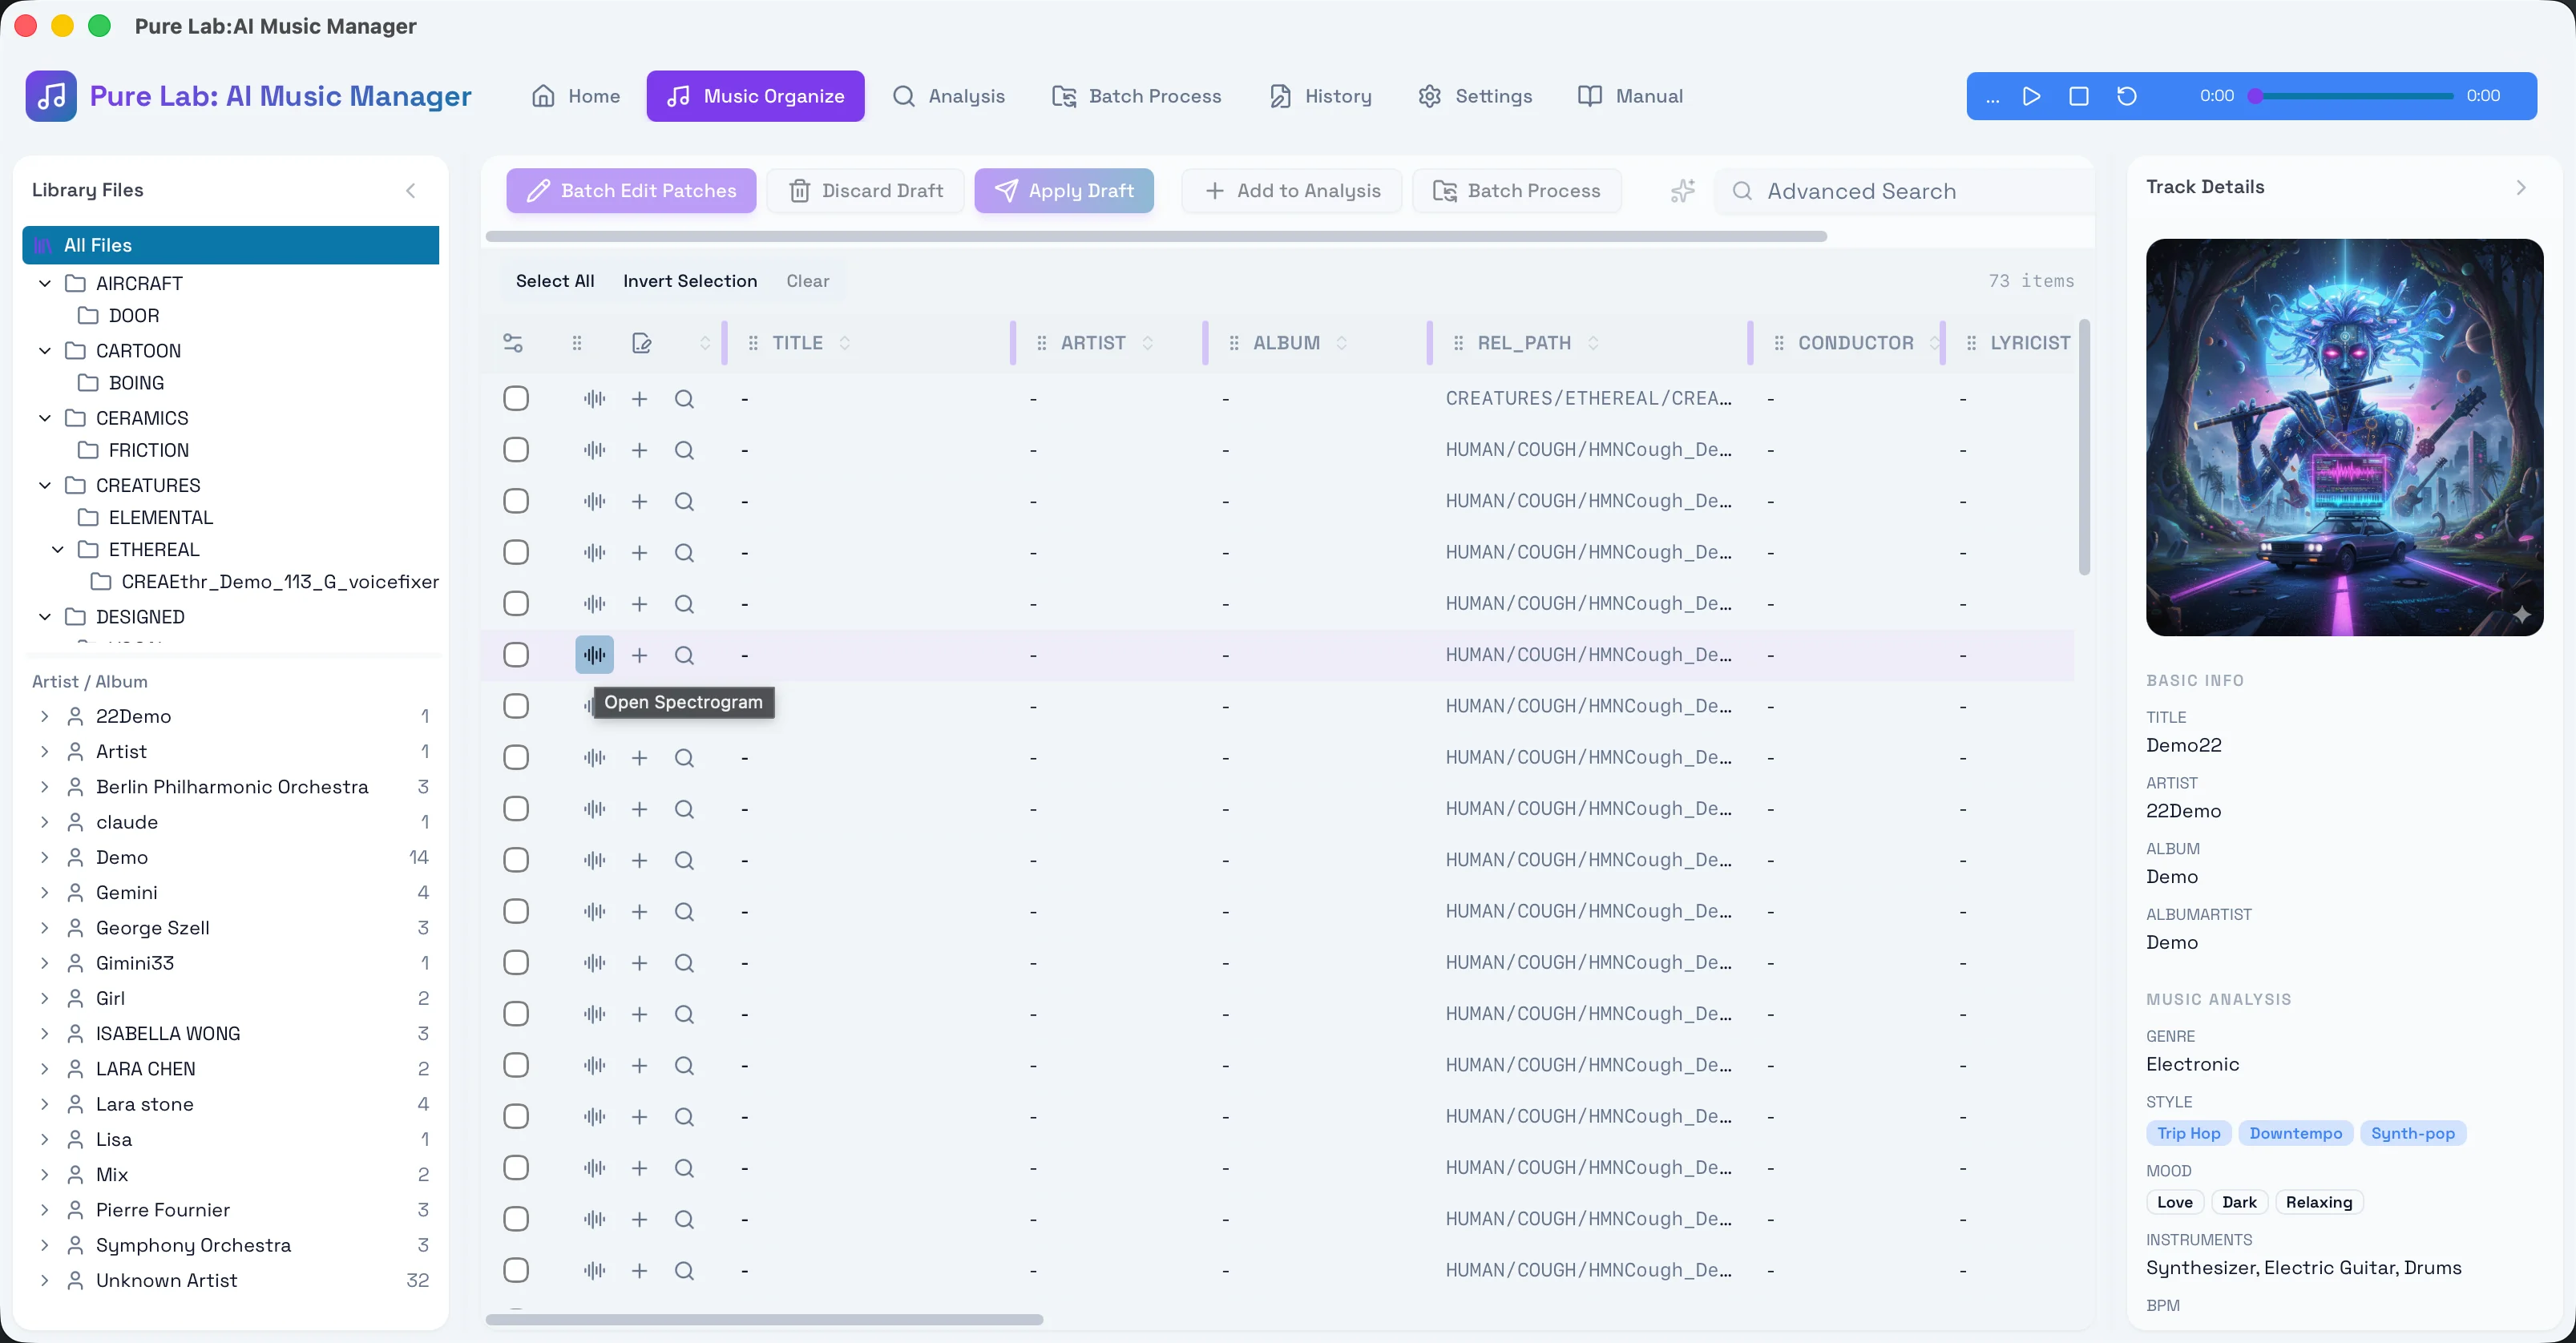
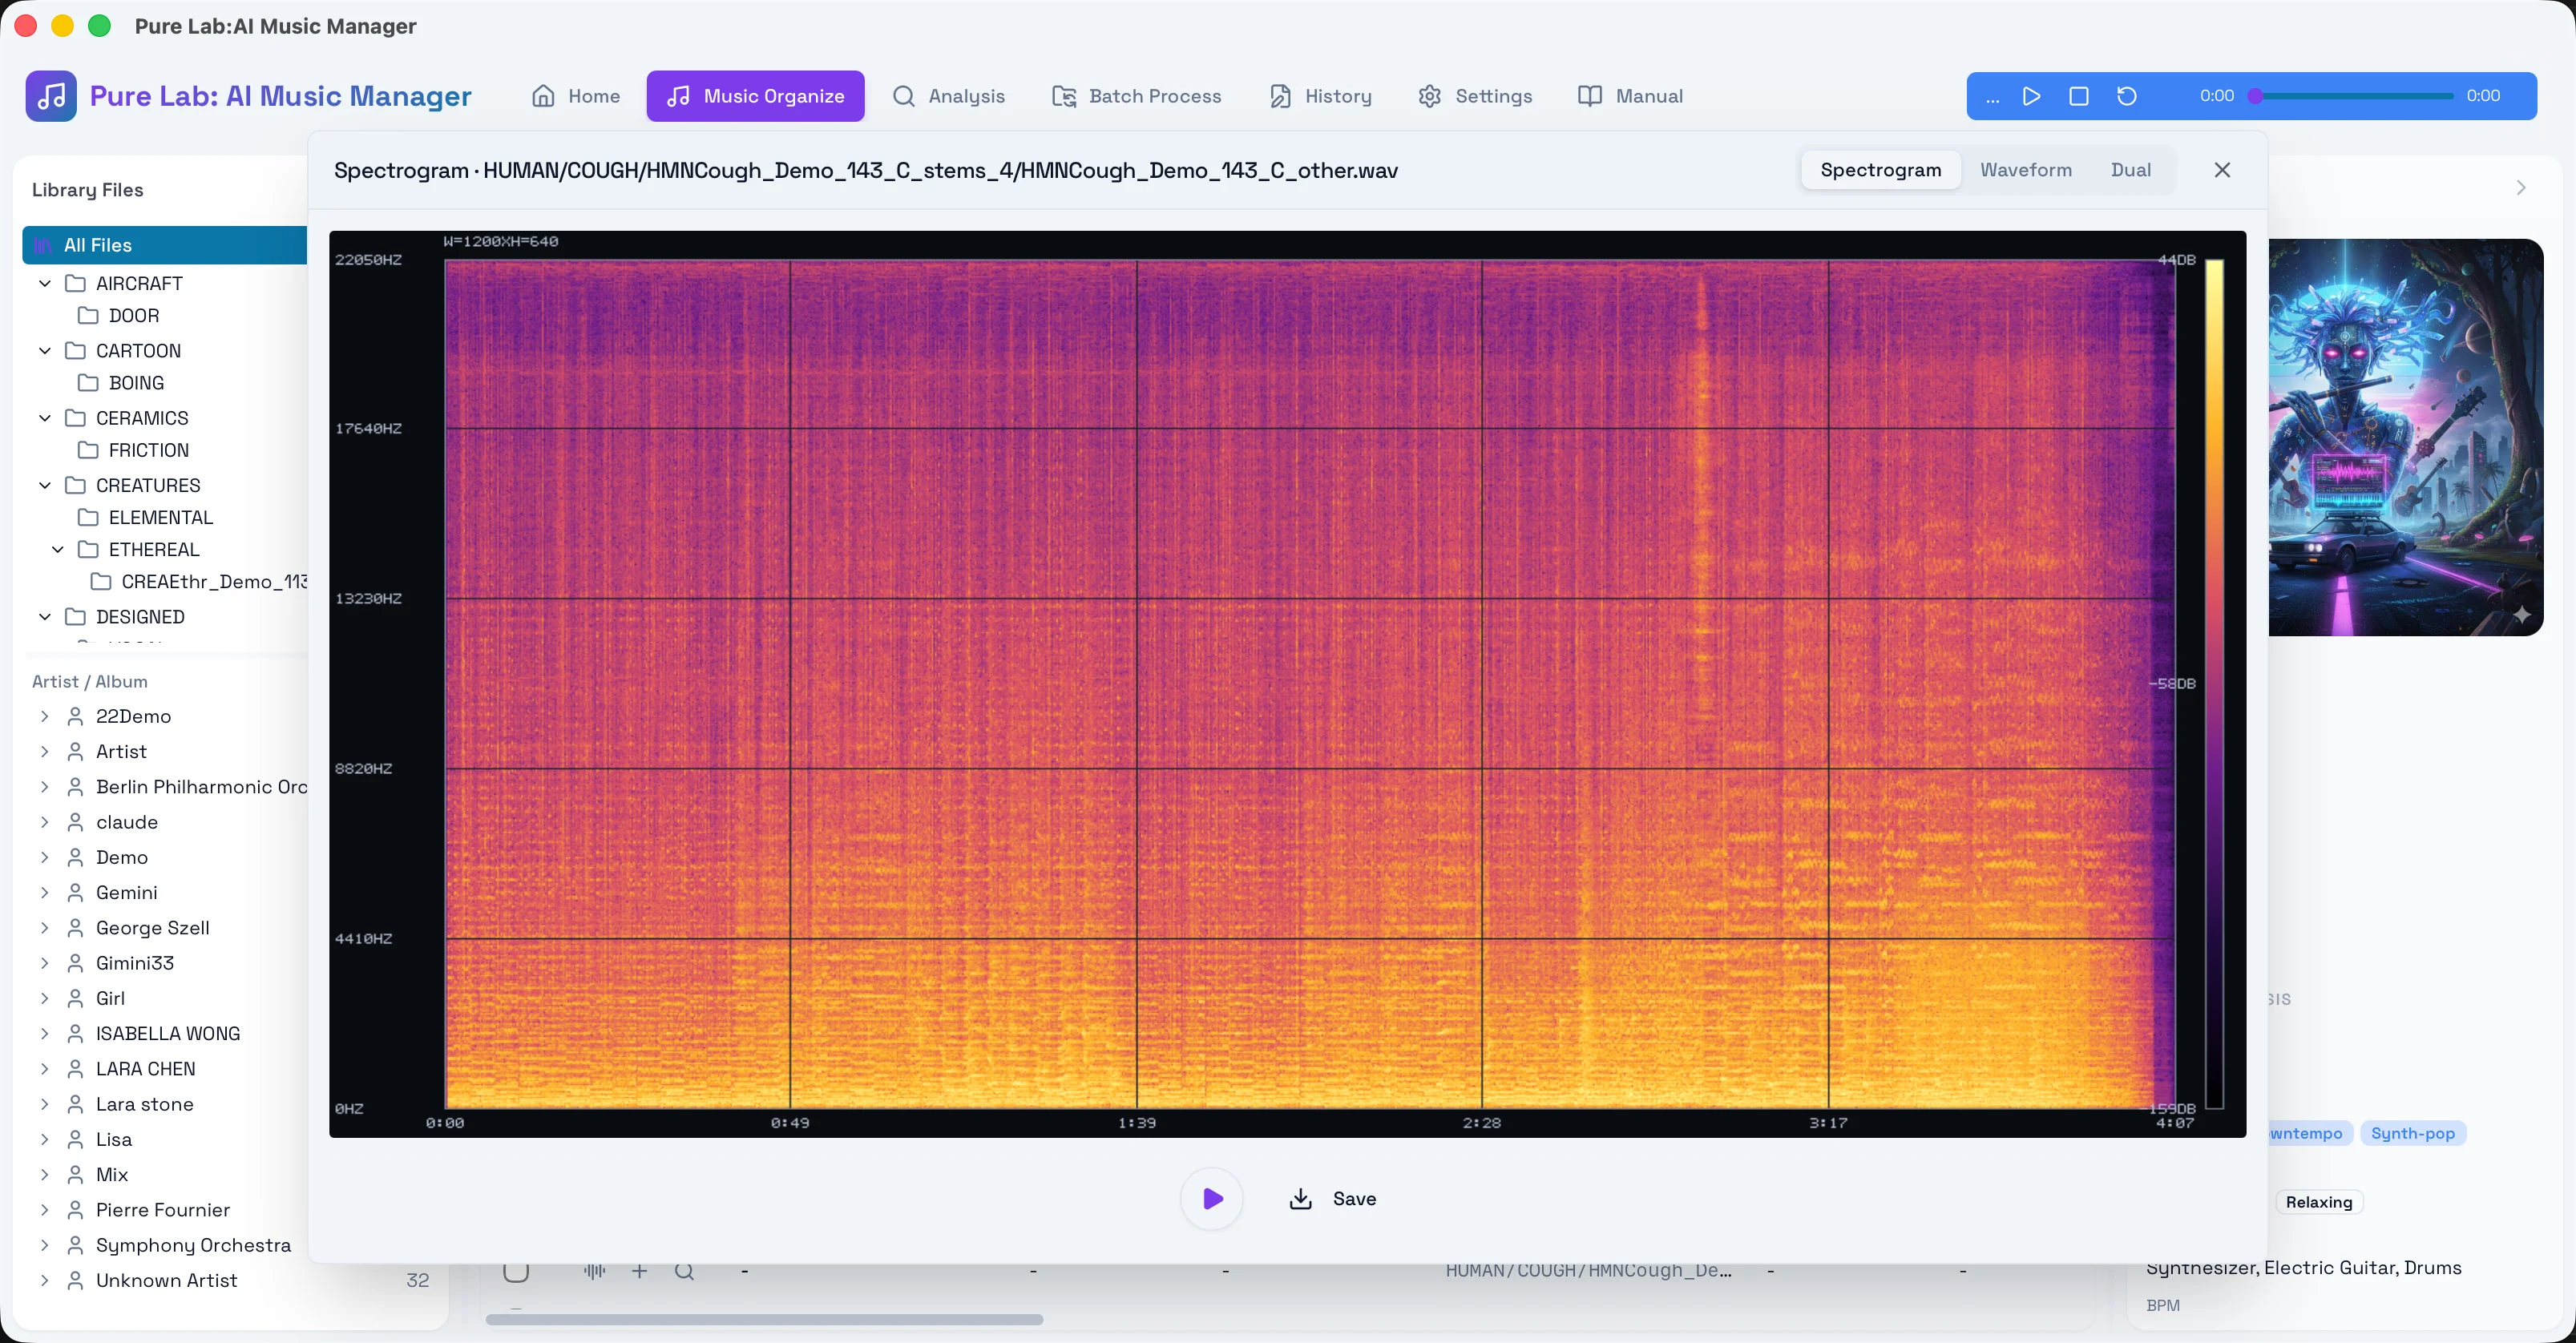
如上图所示,当你在音频整理时,面对标注为“24bit/192kHz”的高清无损格式,你可以直接调出频段弹窗。我们在引擎底层计算出 PURE_QUALITY_CUTOFF_HZ 和对应的置信度分数:
- TRUE_HIRES (真实高解析)
- SUSPICIOUS_UPSAMPLING (疑似上采样造假)
- SUSPICIOUS_LOSSY (疑似有损转码)
为了避免误伤发烧友的原始 DSD(DFF/DSF 格式带来的高频噪声整形往往会被传统算法误判),我们将这一过程深度融合于解码器环节,提取原生 PCM 采样率对应的能量衰减瀑布图。这使得系统能够在用户决定写入标签之前,智能且精确地防患于未然。
结语
基于这两条核心通道,AI Music Organizer 在兼顾本地数据隐私的同时,开创了一条性能和安全并重的标签元数据分析之路。在接下来的系列技术解析中,我们还将深入探讨背后的检索引擎和多语言语义架构,敬请期待。